01
任务与接触
保持、滑移、滚动、换指、释放
先说明要完成什么接触过程,再定义成功。
BODex · Labimus · LabDex在可控的虚拟环境里,探索灵巧手如何完成操作、为什么失败、哪些方法更有效,再检验这些结果能否在真实机器人上成立。
投入精力的漏斗与技术系统的层次分开;七篇精读由机制互补选出。
每层都可能产生迁移误差。单独增加物理保真或样本量,无法替代对其他层的检查。
保持、滑移、滚动、换指、释放
先说明要完成什么接触过程,再定义成功。
BODex · Labimus · LabDex形态、驱动耦合、饱和、延迟
URDF之外,还要固定腕部约束、增益与控制时钟。
DexMachina · Tendon Hand MPC刚柔耦合、摩擦、非穿透
只为会改变策略行为的物理误差支付计算成本。
Taccel · TacEx · SuperDex净力、深度、凝胶、光学图像
给策略什么,以及真机能否用同一方式取得。
Tacmap · PTLD · Dex-X扩增、重定向、探索、筛选
样本量之外,衡量接触类型与有效轨迹的覆盖。
DexMimicGen · SPIDER · CHORD失败预测、排序一致、采集成本
最终验收仿真是否改善真实机器人行为。
DexScrew · TeleOpBench原六篇保持原有阅读顺序,补入HydroShear。论文笔记合计62幅图、36张表;公式沿各笔记的原登记口径。
六方向重力测试验证稳定抓取。基准main与原论文baseline参数不同;它不直接证明长程操作能力。
完整论文笔记 · 8图 / 4表 ↗H100 80GB、4096环境对应特定配置;全手17块凝胶属于另一组吞吐测试。不要把净力、凝胶形变和光学图像视为同一种触觉。
完整论文笔记 · 8图 / 2表 ↗真机实验另外采集40条真实轨迹,测试20次得到90%。真实收益包含采集闭环,不能概括成全部视觉策略零样本迁移。
完整论文笔记 · 7图 / 3表 ↗评估按物体部件计算ADD-AUC;悬浮腕与特权观测限定结论。仓库已存在评测代码,README中的TODO有滞后。
完整论文笔记 · 8图 / 0表 ↗简化仿真学指步,再用真实触觉与历史信息补齐。95%不是95%的任务全部成功;螺丝刀预先插入。
完整论文笔记 · 6图 / 7表 ↗六类仿真专家平均65.9%,与真机cube指标分开。仍需运动参考和资产;公开GitHub入口是网页模板,算法代码未确认发布。
完整论文笔记 · 8图 / 10表 ↗用30个真实样本标定、40个样本检查marker场。模型保留黏着与滑移历史,输出进入策略观测;底层动力学仍由Isaac Gym/TacSL负责。它补上触觉机制,不直接证明多指换指能力。
完整论文笔记 · 17图 / 10表 ↗可按技术主题、阅读层级筛选;每篇保留纳入理由、结论边界与官方来源。
DexMimicGen: Automated Data Generation for Bimanual Dexterous Manipulation via Imitation Learning
数据为何纳入 双臂示范变换、同步和任务成功过滤;仿真用于扩增
阅读边界 真实执行采集后训练;不是纯合成视觉策略直接迁移
全文+图表公式核验 · arXiv:2410.24185DexMachina: Functional Retargeting for Bimanual Dexterous Manipulation
策略为何纳入 从动作像人到物体功能一致;虚拟物体控制器课程
阅读边界 悬浮双手、特权状态、仿真评测;不推出真机手型总排名
全文+图表公式核验 · arXiv:2505.24853Taccel: Scaling Up Vision-based Tactile Robotics via High-performance GPU Simulation
接触触觉为何纳入 统一刚柔接触与触觉信号;直接回答精度—吞吐权衡
阅读边界 低分辨率双指速度不可套用于全手高密触觉
全文+图表公式核验 · arXiv:2504.12908Learning Dexterous Manipulation Skills from Imperfect Simulations
真机闭环为何纳入 简化仿真学指步,真机采集补触觉与螺纹动力学
阅读边界 95% 是进度比;起始状态已装好螺母或插好工具
全文+图表公式核验 · arXiv:2512.02011Dex-X: Learning Visual-Tactile Dexterous Manipulation From Human Videos with Simulated Interaction
数据为何纳入 最新视频→仿真交互→触觉补全→视觉触觉策略
阅读边界 仍需物体资产与动作参考;任务、分布与模态条件需分开
全文+图表公式核验 · arXiv:2609.07747BODex: Scalable and Efficient Robotic Dexterous Grasp Synthesis Using Bilevel Optimization
评测为何纳入 接触力可行性优化与统一动态抓取验证
阅读边界 main 与论文 baseline 物理参数不同;静态抓取不等于操作
全文+图表公式核验 · arXiv:2412.16490TacEx: GelSight Tactile Simulation in Isaac Sim -- Combining Soft-Body and Visuotactile Simulators
接触触觉为何纳入 软体、触觉成像与 Isaac Lab 集成
阅读边界 模块组合的成本与仿真到真机证据分别检查
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2411.04776DexGarmentLab: Dexterous Garment Manipulation Environment with Generalizable Policy
接触触觉为何纳入 柔性衣物、15 类场景及结构对应扩增
阅读边界 不能用刚体抓取成功率衡量布料任务
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2505.11032TeleOpBench: A Simulator-Centric Benchmark for Dual-Arm Dexterous Teleoperation
评测为何纳入 30 项双臂遥操作仿真任务及镜像真机比较
阅读边界 遥操作评价与自主策略泛化不是同一问题
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2505.12748HumanoidGen: Data Generation for Bimanual Dexterous Manipulation via LLM Reasoning
数据为何纳入 原子灵巧操作与空间约束生成示范
阅读边界 LLM 规划质量与物理执行成功须分开
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2507.00833Labimus: A Simulation and Benchmark for Humanoid Dexterous Manipulation in Chemical Laboratory
评测为何纳入 粉体、铰接仪器与精度容差的实验室仿真
阅读边界 完成操作不保证称量结果满足实验要求
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2606.31037LabDex: A Hierarchical Benchmark for Dexterous Manipulation in Laboratories
评测为何纳入 原子技能→组合技能→长程实验的跨平台协议
阅读边界 摘要级核验;尚不据此宣称全部代码可运行
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2608.18618Morphology and actuation as inductive biases in robotic hand manipulation
本体为何纳入 分开分析运动学映射与驱动映射的条件数
阅读边界 限定两种手和任务;人体相似度不是控制便利性的充分条件
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2609.05206Blind Dexterous Grasping via Real2Sim2Real Tactile Policy Learning
真机闭环为何纳入 接触事件校准、触觉编码、专家聚合
阅读边界 20 个实物总体成功率 27%;无视觉仍有真机校准
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2606.11767In-Hand Manipulation of Articulated Tools with Dexterous Robot Hands with Sim-to-Real Transfer
真机闭环为何纳入 仿真基础策略加触觉/力反馈修正关节工具
阅读边界 真实示范参与;不能标为完全零真机数据
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2509.23075Tacmap: Bridging the Tactile Sim-to-Real Gap via Geometry-Consistent Penetration Depth Map
接触触觉为何纳入 共用几何穿透深度表示连接仿真与真实触觉
阅读边界 表示对齐并非完整凝胶剪切动力学求解
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2602.21625Dex4D: Task-Agnostic Point Track Policy for Sim-to-Real Dexterous Manipulation
策略为何纳入 任务无关点轨迹条件技能在部署时组合
阅读边界 目标点轨迹来源与在线跟踪质量也是系统前提
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2602.15828PTLD: Sim-to-real Privileged Tactile Latent Distillation for Dexterous Manipulation
真机闭环为何纳入 用真实特权传感数据蒸馏触觉状态估计,绕开触觉模拟
阅读边界 不需要触觉模拟不等于不需要真实数据
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2603.04531Learning Dexterous Manipulation Using Contact Wrench Guidance From Human Demonstration
策略为何纳入 接触扳手空间指导;规模化双手操作基准
阅读边界 4739 项构建任务与1831项评测任务必须分开
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2607.00033UltraDexGrasp: Learning Universal Dexterous Grasping for Bimanual Robots with Synthetic Data
数据为何纳入 双手通用抓取与合成数据扩展
阅读边界 抓取覆盖度不能直接外推连续工具操作
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2603.05312Dexterous Manipulation Policies from RGB Human Videos via 3D Hand-Object Trajectory Reconstruction
数据为何纳入 RGB 视频重建手物轨迹后在仿真中学策略
阅读边界 几何重建和接触校准仍是关键依赖
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2602.09013Sim-to-Real Reinforcement Learning for Vision-Based Dexterous Manipulation on Humanoids
真机闭环为何纳入 real-to-sim 调参、奖励设计、分治蒸馏与视觉表示
阅读边界 三项任务证据;自动调参不同于无需硬件标定
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2502.20396Dex1B: Learning with 1B Demonstrations for Dexterous Manipulation
数据为何纳入 十亿级示范、几何约束生成与动态任务测试
阅读边界 示范数据单位、有效接触和任务覆盖比总量更重要
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2506.17198DexGraspNet 2.0: Learning Generative Dexterous Grasping in Large-scale Synthetic Cluttered Scenes
数据为何纳入 杂乱场景的大规模抓取合成与深度恢复
阅读边界 抓取场景和测试协议需与 BODex 分开
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2410.23004Sampling-Based Model Predictive Control for Dexterous Manipulation on a Biomimetic Tendon-Driven Hand
本体为何纳入 腱绳手采样 MPC;仿真作为在线预测模型
阅读边界 任务目标仍需适配,非完全免调参通用控制
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2411.06183Grounding Sim-to-Real Generalization in Robotic Manipulation: An Empirical Study with Vision-Language-Action Models
真机闭环为何纳入 一般机器人 VLA 仿真到真机实证研究
阅读边界 当前官方标题已写 Robotic;不作为多指手专属核心证据
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2603.22876Does Imitation Learning Preserve Temporal Robustness in Dexterous Manipulation? An Expert-Learner Comparison Across Task Execution Speeds
评测为何纳入 任务速度变化暴露阶段性失效
阅读边界 作为时间鲁棒性方法参考,不作为多指灵巧手代表
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2609.01453Structural Action Transformer for 3D Dexterous Manipulation
策略为何纳入 结构化动作建模
阅读边界 本文调研重点是仿真链条,策略架构仅侧链
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2603.03960FlowHOI: Flow-based Semantics-Grounded Generation of Hand-Object Interactions for Dexterous Robot Manipulation
数据为何纳入 人手物体交互生成
阅读边界 动作生成不自动保证闭环物理执行
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2602.13444TouchWorld: A Predictive and Reactive Tactile Foundation Model for Dexterous Manipulation
真机闭环为何纳入 预测与反应触觉模型
阅读边界 触觉世界模型不等价于可验证的接触求解器
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2607.07287Grasp to Act: Dexterous Grasping for Tool Use in Dynamic Settings
策略为何纳入 面向工具用途的动态抓取
阅读边界 补充任务语义,非仿真平台或接触建模主线
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2602.20466MuJoCo Playground
平台为何纳入 批量仿真与学习环境基础设施
阅读边界 平台能力不等于任一多指任务可直接复现
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2502.08844ManiSkill3: GPU Parallelized Robotics Simulation and Rendering for Generalizable Embodied AI
平台为何纳入 GPU 物理与渲染并行的机器人任务框架
阅读边界 吞吐结果取决于任务、观测和配置
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2410.00425A Survey of Robotic Navigation and Manipulation with Physics Simulators in the Era of Embodied AI
平台为何纳入 仿真器领域全景索引
阅读边界 综述是检索入口,不作为具体功能实现的唯一依据
官方摘要/元数据;局部原文或已有笔记交叉 · arXiv:2505.01458Dexonomy: Synthesizing All Dexterous Grasp Types in a Grasp Taxonomy
数据为何纳入 按抓取类型而非仅总量扩展数据;BODex官方推荐后继
阅读边界 31类型、9.5M抓取;类型覆盖不代表接触时序覆盖
官方摘要/元数据;追溯重点项目引用 · arXiv:2504.18829ManipTrans: Efficient Dexterous Bimanual Manipulation Transfer via Residual Learning
策略为何纳入 通用轨迹模仿器与任务残差;重要功能重定向对照
阅读边界 基准跨平台再实现需区分论文原始系统
官方摘要/元数据;追溯重点项目引用 · arXiv:2503.21860SPIDER: Scalable Physics-Informed Dexterous Retargeting
数据为何纳入 物理采样与虚拟接触课程生成动态可行轨迹
阅读边界 2.4M是帧,不是完整示范;10倍加速需保留任务与硬件条件
官方摘要/元数据;追溯重点项目引用 · arXiv:2511.09484HydroShear: Hydroelastic Shear Simulation for Tactile Sim-to-Real Reinforcement Learning
触觉观测为何纳入有历史的剪切观测、真实标定和策略验证;共享触觉机制补入核心层
阅读边界双平面GelSight Mini并行夹爪;标定触觉模型不等于唯一辨识真实材料或全动力学;无全手实验,无去历史等逐因素定量消融。
2026-09-14复核既有全文笔记、17幅图、10张表、公式与公开代码;未运行训练 · arXiv:2603.00446没有匹配的论文,请调整关键词或筛选条件。
区分物理引擎、任务环境、传感组件与方法管线。提交ID链接锁定核验快照;公开入口不等于完整复现。
| 仓库 / 所在层 | 可见发布内容 | 复现边界 | 核验快照 |
|---|---|---|---|
| NVlabs/dexmimicgen数据/环境 · robosuite / MuJoCo | 环境、数据下载、BC-RNN配置入口:scripts/generate_training_config.py | 确认发布内容;在线生成器完整性不能从论文推定许可:NVIDIA Source Code License;数据CC-BY4.0 | 940e8a1b3a ↗ |
| MandiZhao/dexmachina功能重定向 · 定制Genesis + rl_games | 手资产、训练、ADD-AUC评测入口:dexmachina/rl/eval_rl_games.py | README TODO滞后,评测代码与数据入口实际存在许可:MIT | adae5bf620 ↗ |
| Taccel-Simulator/Taccel接触/触觉 · ABD-IPC / Warp | 源码、传感构建、插入和Tac-Man示例入口:examples/peg.py | 精度、网格和环境数影响端到端速度许可:MIT | cb23bc251b ↗ |
| x-robotics-lab/dexscrew仿真到真机 · IsaacGym + XHand | 专家、学生、部署;真机训练连到skill-teleop入口:configs/train/XHandHoraScrewDriver.yaml | 旧依赖;训练步数多种口径需run级追溯许可:MIT | 3bde4e3a4d ↗ |
| JYChen18/BODex抓取合成 · cuRobo / QP / Coal | 合成和规划入口、资产链接入口:example_grasp/plan_batch_env.py | README推荐后继Dexonomy;用途受分组件许可约束许可:自有CC-BY-NC4.0;cuRobo NVIDIA | 06b9a3c908 ↗ |
| JYChen18/DexGraspBench抓取评测 · MuJoCo | 标准评测、示例数据、baseline分支入口:README.md | main质量100g、kp5;原论文30g、kp1许可:需逐项查看LICENSE/依赖 | d9ea6cf282 ↗ |
| DH-Ng/TacEx触觉扩展 · IsaacSim4.5 / IsaacLab2.1.1 / UIPC | GelSight Mini、Taxim、FOTS与软体集成入口:README.md | beta;论文GIPC与当前UIPC路线有版本差别许可:MIT及第三方组件条款 | adceed41af ↗ |
| wayrise/DexGarmentLab柔性操作 · IsaacSim4.5 | 任务环境、资产、数据生成、HALO及基线入口:README.md | 15场景;柔性体和资产下载有额外依赖许可:代码及HuggingFace资产分别核对 | e4e298e696 ↗ |
| cyjdlhy/TeleOpBench遥操作评测 · 动捕 / VR / IK / MeshCat | 相机与VisionPro遥操作流程入口:README.md | README入口不等于已验收所有30任务和4模态许可:本次未完整核对许可 | 4cc410d149 ↗ |
| InternRobotics/UltraDexGrasp多策略抓取数据 · BODex_api / cuRobo | 多种抓取rollout与物体配置入口:rollout.py | README主要给生成管线;不据此声称全策略训练复现许可:Apache2.0;派生依赖保留原许可 | e0f9784a9b ↗ |
| facebookresearch/project_superdex物理/任务平台 · 自有Physics / Robotics / Studio / Lab | 核心模块、示例;Lab早期预览入口:README.md | Teleop Q4 2026为计划;按模块分别评价许可:核心Apache2.0;资产/文档CC-BY4.0,mesh CLI GPLv3等 | 06b5d2b9d6 ↗ |
| google-deepmind/mujoco物理引擎 · MuJoCo / 加速后端生态 | 动力学、接触、模型接口入口:README.md | 引擎与学习任务框架分开选择;不替代系统标定许可:Apache2.0 | 0b5d32047d ↗ |
| google-deepmind/mujoco_playground学习环境 · MJX / MuJoCo Warp | 训练环境、视觉与灵巧操作入口入口:README.md | 后端和资产版本需固定;不同任务不是同一吞吐条件许可:Apache2.0 | 4057c14771 ↗ |
| isaac-sim/IsaacLab学习框架 · Isaac Sim生态 | 任务、传感、控制和策略训练接口入口:README.md | 有平台不等于自动获得某论文的手资产/传感配置许可:核心及底层组件分别核对 | 99f1423e5d ↗ |
| haosulab/ManiSkill操作学习平台 · SAPIEN | GPU物理/渲染、任务和数据工具入口:README.md | v2/v3、任务/渲染设置区分;指标不能无配置比较许可:核心及资产许可分别核对 | 62ff3a5896 ↗ |
| Genesis-Embodied-AI/Genesis物理/仿真平台 · Genesis | 多物理求解与机器人接口入口:README.md | 论文的定制fork不可直接替换为当前上游许可:Apache2.0及资产条款 | b3c6c73a7a ↗ |
| newton-physics/newton物理引擎 · Warp / MuJoCo Warp等 | GPU物理、可扩展求解器与机器人示例入口:README.md | 求解器、可微性、平台支持须按具体功能验证许可:Apache2.0;文档CC-BY4.0 | 5cdf9cbf62 ↗ |
| dexx-code/dexx-code项目网页 · HTML/CSS页面模板 | 论文展示页面;未见训练算法入口入口:README.md | 排除出可运行算法项目;保留最新论文观察许可:网站模板CC-BY-SA4.0不代表算法许可 | 0cb9766bd2 ↗ |
| MMintLab/hydroshear触觉观测/任务训练 · IsaacGym / Preview TacSL | 模型、demo、四类任务、教师/学生训练、play;README提供插入checkpoint下载命令入口:scripts/experiments/hydroshear/train_student_aacd.py | 有历史的marker位移观测;未见该生成力直接耦合刚体积分器;未发现HydroShear四参数拟合脚本许可:本仓库MIT;IsaacGym及其他依赖另遵其许可 | f815b82fdf ↗2026-09-14 |
原18仓库保留2026-09-10快照;HydroShear于9月14日复核。许可按代码、资产、数据与依赖分别记录。
以下是建议的实验设计。没有把论文结果当作本次复现实测。
BODex / DexGraspBench起步。固定一个手与10–20个物体,测试摩擦、质量和延迟;记录滑移、掉落与仿真/真机排序。
退出条件:仿真无法预测真机失败时,先定位资产与控制误差,暂停扩数据。
同任务、同预算比较无触觉、指尖力、几何深度与软体触觉。Taccel/TacEx、HydroShear、Tacmap、PTLD提供互补路线。
退出条件:图像相似度提高而真机策略没有改善时,回到任务所需状态与标定。
分别比较示范扩增、功能重定向与简化仿真辅助采集;记录GPU时、真机人时、有效轨迹率及接触类型覆盖。
退出条件:样本更多但未见任务收益停滞时,优先补接触策略与失败恢复示范。
展开阅读两年的变化、五种技术路线、指标口径与既有笔记关联;HydroShear和sandbox用途补充在原结构中。
核心判断 我们讨论的是:在可控的虚拟环境里,探索灵巧手如何完成操作、为什么失败、哪些方法更有效,再检验这些结果能否在真实机器人上成立。 仿真的对象既有物理状态,也有传感信号、执行器、控制时钟、任务分布和评价协议。引擎名字、画面逼真度和FPS,只能回答其中一部分。
本报告把灵巧操作限定为多指手或双手通过接触完成抓取、重定向、手内调整、工具使用、柔性物体处理和组合操作。普通夹爪、通用VLA和世界模型通常作为邻接证据,单列背景;HydroShear因其可共享的触觉机制纳入核心分析,保留并行夹爪的实验边界。“用了仿真”不等于“研究了仿真”;“动作像人”不等于“接触能完成任务”。
阅读入口:完整筛选账本 · 项目核验与路线 · 已有笔记映射。HTML在本目录的附件中,目录链接见文末。
时间窗为 2024-09-10—2026-09-10,按arXiv v1首次提交日期决定纳入;精读使用截至检索日可见的明确版本。首轮仓库按2026-09-10公开状态核验,可早于论文时间窗创立;HydroShear于2026-09-14补核。不把较新的会议年份或更新日期冒充新论文。
这是围绕问题的定向范围调研,不是穷尽arXiv的系统综述。检索采用arXiv限定域关键词、论文引用回溯、项目主页到官方仓库追踪,以及现有Obsidian全文检索。没有把搜索引擎命中总数虚报为已筛选论文数。
| 入口/阶段 | 实际数量 | 通过条件 | 去向 |
|---|---|---|---|
| arXiv可审计候选 | 38篇 | 已核对官方标题、v1日期、摘要和来源链接 | 全部逐项登记 |
| 核心问题层 | 29篇 | 多指/双手任务及直接相关的共享组件,涉及仿真物理、感知、数据、控制或验证 | 按问题分层比较 |
| 邻接背景层 | 9篇 | 通用基础设施、一般操作评测或策略/世界模型侧链 | 不冒充灵巧仿真核心证据 |
| 完整精读层 | 7篇 | 机制互补、证据可取、能代表不同技术取舍 | 原6篇,补接已有HydroShear完整笔记 |
| GitHub独立入口 | 19个仓库 | 官方主页/论文/组织链接+README/源码核验 | 18个技术项目,1个项目网页仓库 |
| Obsidian独立入口 | 222个关键词匹配文件(9月10日) | 包括日报、概念与重复引用;不计作222篇研究论文 | 累计20条映射:17篇可定位,3条保留为历史线索 |
| 可执行决策层 | 3条实验路线 | 明确任务、假设、基线、配置与退出条件 | 实验设计,尚未执行复现 |
这里的漏斗有两种“分层”:先按证据筛选投入精力,再按技术层解释问题。它们不是把29篇排成单一分数榜。七篇精读不代表七个最好的算法;Dex-X代码未确认公开仍被选中,是为了分析最新论文的机制和证据边界。
9月14日补漏: 原37篇候选、6篇精读之外,接入9月13日已单独整理的HydroShear;保留原检索时间窗,不把本次补充描述为重新穷尽检索。
精读组合:BODex(抓取物理验证)、Taccel(接触触觉求解)、HydroShear(有历史的触觉观测)、DexMimicGen(示范扩增)、DexMachina(功能重定向)、DexScrew(不完美仿真与真机闭环)、Dex-X(视频到视觉触觉策略)。
| 技术层 | 真正要问的问题 | 最小实验/可测量量 | 代表线索 |
|---|---|---|---|
| 任务与接触 | 手需要保持、滑动、滚动、换指还是释放接触?目标是物体姿态还是工艺精度? | 接触模式、阶段完成、扰动恢复、精度容差 | BODex、Labimus、LabDex |
| 本体与执行器 | 关节和电机是一一对应吗?腕部能自由移动吗?摩擦、腱绳、回差、饱和与延迟怎么进入动作? | 力矩/速度限幅、控制增益、负载响应、动作频率 | DexMachina、Tendon Hand MPC、Morphology and actuation |
| 物理求解 | 接触和形变用什么状态与近似?什么误差会改变策略行为? | 穿透、滑移阈值、力分配、软体形变、时间步敏感性 | Taccel、TacEx、SuperDex |
| 传感与观测 | 给策略的是物体真值、指尖净力、压力图还是光学触觉?真机能否取得? | 噪声、遮挡、迟滞、频率、标定误差、观测延迟 | HydroShear、Tacmap、PTLD、Dex-X、Blind Grasping |
| 数据与策略 | 用仿真规划、探索、筛选还是扩增?新增样本是否带来新接触策略? | 有效轨迹率、类型覆盖、物体划分、学习曲线、端到端GPU时 | DexMimicGen、Dexonomy、Dex1B、SPIDER、CHORD |
| 校准与真机验证 | 仿真中的排序、失败和收益能否预测真实世界? | 独立试验、未见对象、跨参数曲线、sim/real排序一致性 | DexScrew、TeleOpBench、视觉Sim2Real RL |
以下是报告的系统分析记号,不是某篇论文提出的新定理:
x是物理状态,Fθ是物理演化,Hφ是可依赖状态历史的传感生成(实现中可用递推状态压缩历史),Cψ是把策略动作变成执行器输入的控制链,g是任务目标。真实迁移失败可能来自任何一段;调大摩擦随机化无法保证补偿错误的控制延迟,也不能消除视觉观测中的特权泄漏。
仿真也可以作为sandbox:执行动作、生成数据、重放失败,并改变接触、观测或控制条件来比较替代方案。Benchmark是其中冻结任务分布、初态、接口、预算和计分协议的一环,而不是另一种独立用途。例如DexGraspBench把候选抓取放到相同加载条件下比较;发现某类失效后,又可回到沙盒中改变条件追查原因。可重置、可观测、可干预对各类仿真都重要;灵巧操作尤其要保留接触预载、剪切历史和控制状态。即使暂时没有真机,这些能力也能用于方法比较和调试;是否能外推到真实任务需要另外检验。
抓住一个静态物体、在手里转动、双手交接、用刮板保持工具—桌面接触,是不同约束问题。多指手可能只是充当一个高维夹爪,也可能真的需要指间换接触。数据与评测必须说明它究竟覆盖哪种情况。
BODex的六方向抗重力测试适合筛掉不稳抓取,但不包含长程技能链。DexScrew的螺母预装、螺丝刀预插,所以其结果不能直接等同于从散件完成装配。Labimus进一步指出,做完称量动作并不意味着达到实验容差。BODex §V、DexScrew局限、Labimus。
需要同时审查碰撞网格、质量惯量、关节限位、驱动耦合、控制增益和腕部约束。DexMachina对手资产做过质量/惯量与碰撞处理,并采用6-DoF悬浮腕;其手型差异是在这一组建模和控制条件下观察到的。腱绳手的采样MPC则说明仿真也可以用作在线短时预测模型,不必都走离线大规模RL。对手型的研究应拆开运动学雅可比和驱动矩阵,外观越像人并不保证控制条件数更好。DexMachina附录、Tendon Hand MPC、Morphology and actuation。
触觉相机图像逼真,可以来自渲染模型;力分配合理,需要动力学和材料参数支持。指尖净力、接触位置、几何压痕、凝胶形变、光学图像属于不同抽象层。
Taccel用刚柔统一求解保留凝胶形变;Tacmap把仿真和真实信号映射到共同几何深度表示;PTLD用真实特权传感与触觉数据学习状态估计,绕开触觉模拟。这三条路各自降低不同误差,并不互相否定。Taccel、Tacmap、PTLD。
HydroShear补上了“接触历史”这一层:它跟踪物体表面点在接触中的累积量,经摩擦限幅描述黏着与滑移,再汇聚成marker位移场。因此,相同的当前位姿,经历不同的横移、滑动或重新接触后,可能产生不同触觉。在已核查的公开任务中,它从Isaac Gym/TacSL推进后的位姿生成观测,没有把输出回写为刚体接触力来替换底层solver。恢复中途状态时,也不能只恢复物体pose而丢掉这段历史。
它用30个真实标定样本(按压、组合剪切、受控滑动各10个)拟合有效参数,另用40个样本测试dilation、shear、twist与roll。四项真机任务合计112/120次成功;这些是带两块GelSight Mini的并行夹爪实验,其中插入与抽屉任务分别从已抓持物体、已夹住把手的状态开始。结果支持这组条件下的触觉迁移,不能直接当作多指全手换指能力。局部剪切场计算比原FOTS快、比重实现FOTS慢,也不宜概括为全面提速。方法、分项结果和代码边界见HydroShear完整笔记及原文实验。
DexMimicGen把少量示范变成可执行的新轨迹,DexGraspNet2扩大杂乱场景抓取数据,BODex把抓取几何与接触力可行性、执行姿态和动态筛选连接起来。TacEx则展示在既有Isaac平台中插入触觉和软体模块的路线。共同关注点是让仿真成为有任务语义、可重复利用的数据生产和验证设施。DexMimicGen、DexGraspNet2、BODex、TacEx。
DexMachina、ManipTrans和SPIDER将人类运动转换为机器人真正能执行的交互;Dexonomy强调31类抓取类型,Dex1B扩大示范数量;DexGarmentLab把柔性衣物纳入场景;Taccel为刚柔接触与高密触觉支付额外算力。另一端,DexScrew反过来证明:可以让仿真只负责学适当的指步,把难以模拟的细节交给真实数据闭环。ManipTrans、Dexonomy、SPIDER、Dex1B、DexGarmentLab。
Dex4D以点轨迹条件组合技能;Tacmap与PTLD选择不同触觉对齐路线;CHORD在物体接触扳手空间提供指导;实验室基准把精度与长程任务纳入评价。最新Dex-X将仿真当作视频中缺失触觉监督的补全环节,但其部署仍需要运动参考,较大物体几何变化下成功率也明显下降。Dex4D、CHORD、LabDex、Dex-X v2。
这是本报告对所选样本的归纳,不是按年份证明整个领域已经完成某个阶段。2026年的新结果仍包括预印本与初始发布,工程稳定性要另外检查。
| 路线 | 仿真负责 | 真实世界仍负责 | 合适的问题 | 主要风险 |
|---|---|---|---|---|
| 高保真接触 | 凝胶、摩擦、非穿透、力学演化 | 材料和传感器标定 | 剪切滑移、触觉设计、非凸接触研究 | 计算成本和参数不可辨识 |
| 共用观测表示 | 构造可与真实对齐的几何/力信息 | 从传感器到共用表示的标定 | 快速触觉RL、表示迁移 | 共用表示丢失对任务重要的状态 |
| 物理约束数据生成 | 变换、规划、执行、失败过滤 | 资产构建、演示或标定 | 扩增示范、跨物体初始条件 | “数据增多”但接触策略和错误不变 |
| 功能重定向与课程 | 用物体目标指导接触探索 | 真实驱动与感知转换 | 人类视频/动捕到机器人技能 | 训练特权、虚拟辅助和部署条件混淆 |
| 简化仿真+真实补齐 | 学低成本、可复用技能 | 触觉、恢复、精细动力学 | 仿真难以覆盖的高价值技能 | 真机人时及预先布置被漏算 |
这张表是基于上面论文的技术归纳。选型应从任务失败机制出发:如果失败发生在首次触碰的位置,优先看几何和标定;如果每次接触都对、动作一加速就掉落,优先看执行器与时钟;如果只在胶垫切向滑动时失效,才有理由增加该部分的物理保真度。
| 工作/说法 | 原文实际口径 | 能支持什么 | 不能直接支持什么 |
|---|---|---|---|
| DexMimicGen:21K示范、真机90% | 60条源示范生成仿真数据;真机另由4条源示范辅助采集40条真实轨迹,20次测试 | 指定任务上的采集与学习收益 | 所有任务纯仿真视觉零样本迁移 |
| Taccel:18.30倍实时 | H100 80G、低分辨率双触觉插入;全手17块凝胶是另一组条件 | 该配置下的仿真吞吐 | 任意全手高密触觉均以该速度运行 |
| HydroShear:93.33% | 四项真机任务合计112/120;另用30个真实样本标定传感模型 | 已标定传感器与指定任务初态下的触觉策略迁移 | 多指全手能力、无需真实标定,或替换底层接触solver |
| DexMachina:手型效果 | 按物体部件的ADD-AUC、仿真悬浮腕、特定示范与再实现 | 特定设置下功能重定向与手型适配 | 实物硬件综合排名、完整任务成功概率 |
| BODex:79.9% SSR、81%真机 | 仿真六向重力测试;真实20物体×5次 | 抓取稳定与真实抓取可行 | 手内操作、连续工具使用可靠率 |
| DexScrew:95% | 螺丝刀平均进度比95.00±13.24%,10试验 | 任务推进显著改善 | 95%的独立任务全部成功 |
| Dex-X:65.9%、93% | 65.9%为六类仿真专家均值;93.3%为真机cube28/30 | 指定任务的视触觉迁移 | 六类都93%、任意物体93% |
| Dex1B / SPIDER / CHORD | 分别有“示范”“帧”“任务”单位;CHORD构建4739项、评测1831项 | 不同维度的规模扩展 | 直接比较三个总数大小得出能力排序 |
数字来源为对应精读笔记的完整表格与实验定位;其他来源为Dex1B摘要、SPIDER摘要、CHORD摘要。新项目的摘要承诺、论文实验与本次实际复现是三个层次;本次没有重跑上述实验。
还应避免一个乐观偏差:看到了27%的盲抓真实成功率,仍然可以认为其触觉校准路线有研究价值;没有必要把它改写成“稳定解决盲抓”。Blind Dexterous Grasping。
依据为本次官方README和源码入口核验,详见灵巧操作仿真-GitHub项目与复现路线。尤其要保留三个版本事实:
这些是调研后的实验设计,不是已经获得的实验结论。统一要求:固定仓库SHA、资产校验值、时间步/子步、控制频率、控制增益、观测延迟、随机化范围、种子、终止和成功条件。
采用BODex/DexGraspBench建立可解释基线;同时把Dexonomy作为抓取类型扩展的后继路线。先只选择一个手和10—20个覆盖薄片、长条、圆滑和重心偏置的物体,而不是立即生成百万数据。
以物体为单位划分训练/校准与测试;测试低/高摩擦、质量变化和控制延迟。记录成功率、滑移起始时刻、穿透、力矩峰值和失败类别。若仿真排序不能预测真机排序,应先定位资产/控制误差,暂不扩大数据规模。
在相同手、物体与动作下比较无触觉、指尖力、几何深度表示、软体触觉四种输入;Taccel/TacEx用于高保真对照,HydroShear用于接触历史与剪切观测对照,Tacmap用于表示路线,PTLD作为真实蒸馏路线。
先做接触事件时间、滑移阈值与表示误差测试,再比较相同训练预算的策略收益。分别报告每环境实时率和聚合步数、显存、渲染与学习总耗时。若图像更像但真实策略不改善,说明应回到任务所需状态,而不是继续优化渲染相似度。
任务可由少量源示范覆盖时,采用DexMimicGen式扩增;已有大量人类动作时,比较DexMachina/ManipTrans/SPIDER的功能重定向;关键物理难以模拟时,采用DexScrew式技能采集。Dex-X作为视频—触觉补全的前沿观察项,先解决代码公开与参考依赖。
统一记账:人类标注/采集时长、真实机器人运行时长、生成尝试数、成功保留数、GPU时与未见任务收益。接触类型覆盖不足时,优先增加不同策略与失败恢复示范,而非重复同一条轨迹的轻微位姿扰动。
| 验收项 | 推荐记录 | 为什么 |
|---|---|---|
| 成功 | 每对象、每条件的成功次数/总次数,区间及种子 | 小样本百分比容易过度解释 |
| 泛化 | 未见几何、材质、任务、初始姿态分别测试 | 不把“新位置”当“新技能” |
| 接触 | 滑移、掉落、力峰、非穿透、接触切换 | 失败定位比最终均值更能指导改进 |
| 时间 | 物理步、控制步、传感时间戳、推理耗时 | 保证闭环时序可迁移 |
| 成本 | 仿真/渲染/学习总时间+真机人时 | 避免只优化局部FPS |
| 外部有效性 | sim/real趋势与策略排序的一致性 | 让仿真成为可信测试工具 |
现有笔记分别讨论接触求解、数据闭环、灵巧手触觉和世界模型,本报告将它们连到具体的可测量接口。
所有既有笔记都作为线索或解读来源;关键外部事实优先回到官方arXiv/仓库。共20条重点映射,其中17篇可定位、3条仅保留为历史线索;来源状态及纳入方式见灵巧操作仿真-已有笔记映射。
因此,下一次讨论“灵巧操作仿真选什么”时,最有用的起点是:想改善哪个真实任务、哪种接触失效,以及准备如何检验仿真是否确实帮上了忙。
2026-11-03 整理 · 承接 2026-10-02—11-02 的月度推荐。14 篇与 DexLab 相关工作,另列 1 篇 PDE 背景参考。
本节是基于原文框架的增补,保留上方 38 篇候选、29 篇核心与 7 篇精读的 9 月口径。这里的“相关”指对 DexLab 研究问题有用;通用世界模型、腿式与人形工作均保留其任务边界,不改称多指手实证。以下是文献判断与建议,尚未在 DexLab 复现。
相关性沿用本次推荐评分:14 篇为 4/4,PDE 参考为 3/4;它衡量与研究方向的关联,不是论文质量或方法性能排名。Rollback、RoboJEPA、DiffContact 已有全文笔记;另三篇重点核对相关正文与图表;八篇补读依据摘要及可得正文定向筛选。
沿着 BODex、Labimus 和 LabDex 的问题继续看:66 项任务分 Core-50 与 Transfer-16,用接触建立、协调和目标保持等阶段解释失败。最佳训练多任务策略的 Core-50 成功率为 29.1%。DexLab 可先借鉴阶段诊断,再考虑扩任务库。
阅读边界:Agent 评测披露了门锁指令与原生判据不一致、抬箱豁免 12 N 阈值等例外;应逐任务记录。真机片段是定性演示,不能当作已计分的迁移对照。
首次提交:2026-10-19 · 核查版本:2610.26765v1106 项双手任务把泛化、语言指令、少示范、长时域和记忆放进同一任务矩阵。接在原文“先定义任务与成功”之后,可用来检查现有任务是否只覆盖短时抓持。
阅读边界:跨本体动作接口、调用预算、试验方差和仿真可靠性仍须分别核查。任务数不代表接触类型覆盖完整。
首次提交:2026-10-18 · 核查版本:2610.25459v2用三维潜动作连接人类、机器人和仿真视频,为原文的跨手型讨论补充动作表示路线。它主要连接本体接口与数据层,适合比较不同本体之间能共享的运动信息。
阅读边界:潜动作仍需要目标本体的动作解码与执行约束;跨本体视频预测不等于驱动耦合、饱和或控制延迟已建模。本轮没有新增执行器标定证据。
首次提交:2026-10-27 · 核查版本:2610.36791v1承接 Taccel 与接触模式讨论:保留硬接触前向,在反向使用中心路径松弛的敏感度,让优化器获得跨模式的更新方向。作者报告约 10 万控制样本、不到 2 分钟桌面 CPU 训练的腿式策略。
阅读边界:要分开检查局部导数一致性与更新后原生前向代价是否下降。有限松弛梯度不是硬接触映射的精确导数;点足实验也不能直接覆盖多指抗扭或网格接触。
首次提交:2026-10-26 · 核查版本:2610.35852v1沿着刚柔耦合路线,把 FEM 形变体与每体 12 自由度的仿射体放进同一耦合伴随系统。对夹持布料这样的任务,导数需要保留两边接触与摩擦的相互影响。
阅读边界:约 150× 峰值对应完整 FEM 对照,约 4133× 还含表示差异。方向有限差分检查限于声明的参数点和窗口,共享案例取前 10 帧;不是全轨迹、全方向保证。
首次提交:2026-10-13 · 核查版本:2610.19091v1从原文“给策略什么观测”向预测接口延伸:先预测物体中心的三维运动与形变,再生成视频。这个分解有助于分开检查物理状态预测和渲染误差。
阅读边界:三维或视频预测结果不等于接触力正确,也不能替代闭环策略收益。它没有替代原文的触觉历史与传感标定。
首次提交:2026-10-22 · 核查版本:2610.30781v1用对象槽、时序记忆和最优传输距离,让潜空间的规划接口更贴近对象运动。可接到原文“观测是否包含任务所需状态”的问题上。
阅读边界:表征、记忆和代价共同改变,需要消融区分来源;对象级潜预测尚不等于多指接触验证。
首次提交:2026-10-20 · 核查版本:2610.28074v1从逆动力学学习状态权重,为 JEPA 监督保留与动作相关的信息。它给“用什么距离衡量想象错误”提供了一种行为驱动的选择。
阅读边界:需要状态监督;行为数据中动作可预测的信息不必然覆盖未来任务需求,也不是物理接触量的直接测量。
首次提交:2026-10-27 · 核查版本:2610.36662v1用冻结视觉特征训练跨 12 平台、规模达 8B 的动作条件潜预测器。短 rollout 训练没有清晰的长时域规划提升趋势;延长 rollout 并提高分辨率后趋势改善,提示训练信号应对齐规划用途。
阅读边界:时域与分辨率同时改变,不能只归因于时域。真机每模型—任务 30 次,VLA 参考的目标和控制接口不同;潜误差不是接触力误差,也不构成公平通用排名。
首次提交:2026-10-07 · 核查版本:2610.10515v1共享动力学模型、短时域 BPTT 与模型/策略共同更新,降低大规模人形动作跟踪成本。作者报告单 GPU 3 小时在其动作集上超过大规模既有跟踪基线。它为仿真与模型共同改进提供学习机制。
阅读边界:前向预测、局部动作响应与更新后的原生目标收益须分别检查。人形 tracking 不等于灵巧手操作;低预测误差不保证梯度方向正确,也不能直接搬用训练成本。
首次提交:2026-10-20 · 核查版本:2610.28480v1联合学习潜动力学与动作生成,再用动力学评价候选动作。可与原文的策略学习路线并读,比较直接执行与规划各自贡献。
阅读边界:区分直接策略、动作先验和规划打分。这里指 arXiv:2610.12818,不是另一篇同名工作。
首次提交:2026-10-08 · 核查版本:2610.12818v1接在 DexMimicGen、DexMachina 的少示范与功能重定向之后:从单人类视频的关系图构造多样重置与阶段奖励,让任务关系约束仿真学习。
阅读边界:单视频不等于没有重建与仿真资产成本;先检验重置是否物理可达,再比较接触类型覆盖与真实数据成本。
首次提交:2026-10-08 · 核查版本:2610.12470v1按双手接触角色设计奖励,结合 PPO 与成功轨迹回收。延续原文“动作像人不等于接触能完成任务”的判断,可对照实际支撑、接触迁移和失败恢复。
阅读边界:参考轨迹跟踪与自主完成任务应分开报告;角色奖励与成功回收不能替代接触测量或独立结果判定。
首次提交:2026-10-21 · 核查版本:2610.29997v1保存世界模型上下文,回退到真实轨迹中的决策点并搜索其他动作,再用新真机转移适配模型。同底座 RISE 对照在三项真机任务上提升 10.67、11.11、11.85 个百分点,分母为 150、90、135。
阅读边界:同起点比较须核查隐藏状态与重复波动。48 张 H200 的系统和前期预热不是最低配置;64 条冰壶保真度轨迹参与过适配,不证明未见轨迹泛化。传统模拟器也可以保存与恢复状态。
首次提交:2026-10-26 · 核查版本:2610.36068v1HandsOn 与 BiDex-100 补任务及阶段覆盖;DiffContact 与 DiffGIPC 补接触敏感度检查。先固定失败定义,再问求解器或模型是否真的解释了失败。
DeXplicit、Slot-JEPA 与 SWIM 补预测表示的对照。这些视觉/状态方法没有新增与 HydroShear 等价的触觉标定证据,不能替代原文的同任务、同预算传感比较。
Dex-One2Many、DONIC、RynnWorld-Latent 补数据与跨本体路线;Rollback、RoboJEPA、LeWAM 和 SuperMimic 补模型与策略路线。继续记录有效轨迹率、GPU 时、真机人时和未见任务收益。
2026-11-11 专题增补 · 物理误差 / 任务能力 / 重复性 / 真实预测
2026-11-11 调研结论:优先借鉴评测方法,把接触模型误差、计算重复性、任务完成与真实预测能力分别报告。 SimBenchmark、ContactBench、GPUSimBench、GAUGE 最贴近 DexLab 的物理诊断;DexGraspBench、ContactBench 1.0、HandsOn 提供操作任务设计;SIMPLER 提供仿真是否能帮助选择真实策略的验收思路。任务更多、成功率更高或 FPS 更大,各自只能支持对应范围的结论。
本专题覆盖机器人操作与接触仿真,兼顾柔性物体、任务泛化和 GPU 性能;不把自动驾驶、导航或视频生成的所有 benchmark 收作同一排行榜。以下是代表性调研,不声称穷尽。内容是外部机制分析与迁移建议,没有新增 DexLab 物理实验,也没有改变已有验收协议或工作顺序。
这是自拟的说明例子。瓶子没掉下来,可能是接触真的能承载,也可能是手腕运动、辅助约束或评分窗口掩盖了问题。瓶子转到了目标角度,也可能是整个手腕转动,尚未发生预期的手内换指。放到目标区域后立即计分,还可能接受尚在运动或仍被手指夹住的物体。
同一段动作因此需要几种不同的检查:物体相对手掌的位姿、承载与接触切换、松手后的稳定状态、超时与失败原因,以及计算成本。若要据此选真实机器人策略,还需要在相同条件下对多种策略做仿真与真机配对。这个例子贯穿下面的取舍,不能用任一单项分数替代全部证据。
表中的“可借鉴”是本次分析,不代表已经接入 DexLab。论文覆盖、代码覆盖与排行榜使用的子集可能不同。
| 评测对象 | 工作与主要机制 | DexLab 可借鉴什么 | 结论边界 |
|---|---|---|---|
| 引擎数值与成本 | SimBenchmark:简单碰撞体、接触/多体场景,报告误差与实时倍率。 | 在相同物理问题下画误差—成本曲线,说明控制、步长和预算。 | 历史软件与 CPU 配置;不能照搬为当前 GPU 引擎排名。 |
| 接触模型与算法 | ContactBench / Contact Models in Robotics:统一实现不同接触问题及求解方法,检查互补性、摩擦和数值自洽。 | 区分“模型选择改变了物理行为”和“同一模型求解不充分”。 | 算法重实现不等于各官方引擎全部实现;论文明确讨论了实现差异。 |
| GPU 扩展与重复性 | GPUSimBench:吞吐、显存、批内差异、重复运行差异及真实斜面碰撞分布。 | 把并行环境数也当实验变量,检查扩容是否改变结果。 | 两个扩展性场景和一个真实对照场景,单套软硬件;不覆盖全部接触、柔性或视觉工作负载。 |
| 真实动力学参照 | GAUGE:真实轨迹、物理参数与不确定度,涵盖刚体、绳、织物、体积软体。 | 记录测量重复性、参数来源及机制相关的误差。 | 22 个任务族不等于全部完成引擎评测;论文引擎实验用 14 个任务族。代码发布边界见下文。 |
| 抓取稳定性 | DexGraspBench:MuJoCo 中的桌面提升、外力扰动、解析抓取指标与穿透检查。 | 将初始几何、抓持过程、扰动保持和解析指标分开。 | 当前主分支与论文 baseline 分支不同;稳定抓取不证明换指或长程操作。 |
| 日常接触技能 | ContactBench 1.0:8 类技能、36 项参考任务,可打印机构及阻力变化。 | 用插入阻力、旋转需求等行为变量定义难度,同时报告进度与用力。 | 与上面的求解器 ContactBench 无关;论文任务数、仿真实现数和已评测策略子集要分别计数。 |
| 灵巧操作与迁移 | HandsOn:Core-50 与无目标任务示范的 Transfer-16,含组合与柔性任务。 | 用任务阶段定位首次失败,区分接触建立、协调和已达目标的保持。 | 论文的定性真机展示不构成全任务定量迁移;当前代码扩展也不能并入原论文数据口径。 |
| 操作学习与采样 | ManiSkill3:SAPIEN 上的操作任务、GPU 物理和视觉采样。 | 规范任务接口,并分开测无视觉、带视觉和记录数据时的成本。 | 框架吞吐不等于策略训练吞吐;同一底层引擎的不同框架不是独立引擎样本。 |
| 多任务/元学习 | Meta-World:相关操作任务上的多任务与元强化学习。 | 分开训练任务与未见任务,比较学习预算和适应能力。 | 学习能力基准,没有单独校准接触力和真实材料。 |
| 视觉操作与示范 | RLBench:任务变体、示范生成和多种观测/动作模式。 | 固定任务变体、相机与控制模式,再比较策略。 | 路径规划产生的示范和任务成功判定,不是独立的物理真实性证明。 |
| 知识迁移 | LIBERO:空间、物体、目标及混合知识迁移。 | 保留受控分布变化,避免同时更换物体、目标和控制器后无法归因。 | 常用 LIBERO-10 与完整 130 任务集合不是同一分母;成功率不测材料保真。 |
| 连续任务链 | CALVIN:语言指令串联,报告完成前 1 至 5 项的比例及平均链长。 | 保留跨子任务物理状态,查看失败在哪一环累积。 | 原脚本序列开头重置环境、每个子任务重置模型;物理连续与策略记忆连续要分开。 |
| 双臂鲁棒性 | RoboTwin 2.0:clean / randomized 评测。 | 固定训练数据后测随机化条件下的退化。 | 随机化抗性并不自动等于真实迁移;须注明训练配置及随机化轴。 |
| 场景与组合泛化 | RoboCasa365:Atomic-Seen、Composite-Seen、Composite-Unseen。 | 将见过的基本技能与未见组合分开计分。 | 365 项任务库与当前榜单的 50 个目标任务不同,不能互换成功率分母。 |
| 家庭活动语义 | BEHAVIOR-1K:BDDL 初态/目标、OmniGibson 对象状态与活动。 | 明确任务意图、对象状态和必要事件。 | 部分活动涉及显式状态转换规则;语义完成不能一概解释为连续物理机制已验证。 |
| 柔性物体策略 | SoftGym:布、绳和流体等高维、部分可观测操作。 | 定义形变任务与观测差异,检查覆盖、铺平等任务目标。 | 主要比较策略学习;真实材料验证需要另外的测量参照。 |
| 仿真对真实策略的预测 | SIMPLER:控制和视觉对齐、仿真/真机配对评估。 | 检查仿真是否保留策略优劣次序,并报告绝对成功率误差。 | 结论依赖已测机器人、任务与策略;相关性高不等于接触参数正确。 |
| 持续作业 | HolidayFactory / DexLab 既有分析:job 事件与跨 job 状态。 | 先审计评分,再设计保持—卸载/重建接触—释放的短序列。 | DexLab 中仍是提案;持续状态、恢复和 run 级统计尚未因此完成。 |
近期的 RoboLab 与 RoboDojo 也提供规模化任务评测入口,本次作广度索引,没有审计其完整评分实现。它们的任务目录可供后续选例;当前优先级仍是把已有接触实验的判据与失败解释做清楚。
1. 同时问“解得准不准”和“选的物理模型对不对”。 SimBenchmark 的 rolling 场景将速度与解析参照比较;ContactBench 进一步把接触律偏离、求解精度与步长敏感性拆开。对瓶子抓持,接触模型若缺少必要的抗扭作用,仅增加迭代不一定能保持住。DexLab 已有这种区别的直接证据:Wuji 合成夹球的抗扭接触改变了保持位移,但没有建立真实指垫参数或求解器失效。建议沿已有解析斜面与夹球记录,分别整理参考误差、同模型残差、步长/容差敏感性和耗时;理想刚性库仑关系只在所声明假设下作为参照,不用它无条件否定有意建模的柔顺接触。ContactBench §IV · DexLab Wuji 证据
2. 向真实重复测量对齐,同时保留任务需要的观测。 GAUGE 将几何、物理参数、真实轨迹和实验波动放在一起,避免把一个更细步长的仿真当成真值。其 §3.2 的刚体广义轨迹是位置,织物与体积软体使用各自形变表示;对 DexLab 的瓶子转动,还必须保留姿态、相对手掌旋转和接触事件。它使用的轨迹时间对齐也应与原时间轴误差分开,避免隐藏延迟。先借鉴测量与参数来源的组织方式;真实材料准确性仍要有相应的实物数据。GAUGE §3.2 与附录 B
3. 用并行规模与重复运行检查计算稳定性。 GPUSimBench 区分同一批环境间的差异和独立运行间的差异。DexLab 若后续扩展 GPU 批量接触实验,可在相同初态、输入和计时边界下改变并行数,观察位姿误差、接触丢失及成功判定是否变化,再联合看吞吐和显存。源码中的 MuJoCo Warp 吞吐按“环境数 × 测试步数 / 墙钟时间”计算,包含显式同步;这不是单环境控制频率。还应单列冷启动/编译、稳态步进、观测/渲染和记录成本。这是建议的检查维度,不预设哪种引擎必然不确定。GPUSimBench §III–VII
4. 把成功过程、合理用力与评分漏洞放在同一张结果单上。 DexGraspBench 提供保持与扰动协议,ContactBench 1.0 通过机构阻力改变行为要求,HandsOn 则把复杂任务分阶段观察。迁移到 DexLab 时,先复用现有夹球、释放和 LIBERO 记录审计评分:只进入目标区域、仍被夹持、隐藏支撑、错误事件顺序或直接改写评分状态,分别会不会被接受;合理成功又是否误拒。随后才设计接触阶段任务。ContactBench 1.0 同时报告成功、进度和峰值用力,但其具体力阈值不能直接成为另一只手的安全阈值。ContactBench 1.0 实验 · DexLab 当前设计顺序
5. 最终检查仿真是否帮助作出正确选择。 SIMPLER 的价值是比较同一批策略在仿真与真实环境中的表现。其指标代码同时提供 Pearson 相关性和 mean maximum rank violation(MMRV):后者衡量仿真排错顺序时,涉及的真实表现差距有多大。DexLab 后续若具备配对真机条件,应在未用于调参的条件上同时看绝对成功率偏差、排序错误和不确定度。当前的物理诊断与脚本回放不能冒称这种策略评价已经完成。CALVIN 的链长统计可借来描述连续任务可靠性,但还要声明策略记忆和环境状态分别何时重置。SIMPLER 指标源码 · CALVIN 序列实现
Jiang 等人的 What Are We Actually Benchmarking in Robot Manipulation?(CoRL 2026 Oral, Best Paper Award Finalist)不是在证明“所有榜单都造假”。它更严格的结论是:总分可能同时由目标能力、任务捷径、长期适配的窄测试分布、训练数据距离和统计噪声产生,因而高分未必能唯一识别所声称的能力。直接改 scorer 是一层;即使 evaluator 按设计工作,协议仍可能允许不具备目标能力的系统得高分。
| 诊断 | 论文的最小反证 | 被破坏的榜单解释 |
|---|---|---|
| 缺失能力探针 | LIBERO 上约 0.09B 的 DINOv2+MLP 不读语言,只用 task-ID embedding;Spatial/Object/Goal 为 99.0%/100.0%/98.8%。 | 高分本身不能证明语言理解、模型规模或广泛泛化;也不证明高分 VLA 没有这些能力。 |
| 可检测性与配对统计 | 对只有总分的记录构造 paired Wald 方差上下包络,分成必然显著、必然不显著与无法判断。 | 新分数略高不自动构成进步;无法判断也不等于已证明不显著。 |
| 训练支持内重采样 | CALVIN 保持 1,000-sequence manifest,只重采样训练范围内 block pose;X-VLA/GR-1/RoboFlamingo 的 ATC 下降 1.027/0.749/0.498,95% CI 均不跨 0。 | 长期调参可能适配了窄测试分布。只换 sequence manifest 影响很小,当前证据不支持强样本记忆解释。 |
| 数据来源依赖 | SimplerEnv 中,每任务 120 条贴近官方 grid 的脚本仿真 demo 训练 22M policy,合计 91/96;X-VLA 报告 92/96。 | 同一总分未必证明从真实 BridgeData V2 到仿真测试的跨域泛化。这是偏向测试域的存在性反例,不是公平模型排名。 |
DexLab 不应用又一个总分回应这些结果。Discussion #302 补充的最小顺序是:
这些是单向反证:找到捷径能否定“分数必然证明能力”,未找到当前捷径不能完成 benchmark validity proof。RoboCasa/RoboTwin 2.0 的简单探针明显落后于榜首,只能说它们没被这一探针破掉。这是设计输入,不是 DexLab 新实验结果。
DexLab 已有独立评分、解析斜面、接触保持和任务/诊断分离的记录。本次调研补充的是:怎样给这些结果提供更明确的比较轴,以及哪些外部证据能够改变下一步决策;不把现有工作重新包装成一套新平台。
| 借鉴顺序 | 对应缺口与最小验证建议 | 通过后能说什么;仍不能说什么 |
|---|---|---|
| 先审计评分与能力可识别性 | 基于当前 Wuji / LIBERO 记录准备合理成功和伪完成反例;再去掉一项声称能力并做一个训练支持内重采样,保存逐实例配对结果。 | 可说明已检查反例下判据符合任务意图,且当前最小捷径未复现;不能说明所有漏洞已穷尽或能力已被完整识别。 |
| 再建立接触机制的误差—成本对照 | 在已有合格案例上分开改接触模型、步长或容差;保留绝对误差、敏感性、耗时和全部失败。 | 可说明条件内的数值/任务取舍;不能推为全引擎或真实材料排名。 |
| 有批量运行需求时检查并行影响 | 冻结设备、版本、输入和随机性,改变批量规模并重复独立运行;把记录开/关作为受控变量。 | 可界定该软件栈和场景的稳定区间;不能从终态差异直接断言某个 GPU 内核是原因。 |
| 评分可靠后做短连续序列 | 保持→卸载/重建接触→释放;明确环境、控制器、策略和传感历史的重置边界,以整条 run 统计。 | 可检验错误如何跨阶段积累;不替代既有手内滚动/换指验收。 |
| 具备真实参照后检验选择价值 | GAUGE 式重复测量与 SIMPLER 式多策略配对分开设计,留出条件,报告不确定度。 | 可检验具体物理量或策略排序的外推;无真实记录时保持未验证。 |
这些是候选设计,执行时仍需遵守 DexLab 已冻结的适用引擎矩阵、资源预算与完整验收;一个小例子不会缩小原有义务。现阶段暂缓引入完整家庭任务库、统一替换后端或把各种指标压成一个总分。如果已有评分在有力反例下可靠,而主要误差出现在柔性物体或真实策略排序,优先级才应转向相应的材料测量或 sim/real 配对。
前一轮广度调研读取了论文相关章节、官方项目/评测文档及下列固定版本关键文件,未安装运行这些外部 benchmark、复测排行榜、训练策略或做硬件实验。2026-11-12 增补另外通读 Manipulation Benchmark Audit 全文/附录,并复算其当前公开 CPU 统计产物;没有重跑 policy、仿真 rollout 或真机。表中多数广度条目只核查官方描述,未逐项审计完整实现;“源码可见”也不等于“本轮运行通过”。
GAUGE 的 Hugging Face 数据仓库 可见资产、轨迹与元数据目录;本轮只核查目录,未下载或校验全量数据。其 GitHub 快照仅有说明、许可及媒体,README 仍写评测工具待发布,因此可以研究协议和数据组织,不能称为已核实可直接运行的完整工具链。ContactBench 1.0 则已存在官方项目页链接的仿真仓库:README 列出 22 个基础任务对应 73 个可运行行、另一个仅场景任务,并明确不含策略学习/评估管线;这些发布说明不等于本轮复现,也不能与论文的 36 项参考任务等同。
| 固定快照 | 本轮检查位置与用途 |
|---|---|
SimBenchmark 3fd1764635 |
benchmark/include/RollingBenchmark.hpp、MuJoCo rolling 实现:解析速度误差和耗时记录。 |
ContactBench 76fd04b814 |
contact-problem.hxx、examples/cube.py:不同互补性量与场景入口;论文采用 v3(2024-07-21)。 |
GPUSimBench 7d39254e66 |
公共默认值、MuJoCo Warp 计时、Genesis 斜面脚本;论文采用 v1。没有据此断言所有后端默认参数已等价。 |
GAUGE 5a6207c22d |
仓库树、README 与论文 v1 的 §3、附录 B:发布范围、观测与误差定义。 |
DexGraspBench d9ea6cf282 |
eval.yaml、fc_mocap.py、tabletop_mocap.py:主分支阈值、六向外力与桌面评测入口。 |
ContactBench 1.0 仿真 f51f6aab24 |
仓库树及 README:任务/变体、机构参数来源与策略管线发布边界;未审计全部机构实现。 |
HandsOn fee28452fa |
README、评估边界文件:区分原论文任务、PhysX/Wuji1 示范与后续 Newton/Wuji2 扩展;阶段结论归于论文报告。 |
SIMPLER eddb569074 |
simpler_env/utils/metrics.py:Pearson 与 MMRV;未把相关性解释为参数标定。 |
CALVIN fa03f01f19 |
evaluate_policy.py:默认 1,000 条序列、最多 5 个子任务、环境与模型不同的 reset 位置。 |
Manipulation Benchmark Audit a5ad04ab0f |
CLAIMS.md、claim-to-artifact map、逐 episode/sequence 摘要与统计代码;本轮 recompute_claims.py 和 validate_release.py --skip-exact-inputs 通过。arXiv v1 的 LIBERO 19.8% 与 camera-ready 产物 144/789 = 18.3% 分开引用。 |
与本次迁移判断直接相关的 DexLab 基线是 4867a8637b:docs/current-work.md、incline_score.py、pinch_score.py 和 libero_score_v2.py。其中 LIBERO v2 明确把记录与数值诊断同物理有效性、学习策略评价分开。本专题延续这些边界;不改变原 38 篇论文、19 个仓库的历史计数。
2026-11-12 专题增补 · 评测统计 / 接触诊断 / sim-real 校准
2026-11-12 按 CoRL 2026 官方录取页逐项筛查 687 篇录取论文,先按任务/接触、本体/执行、物理、观测、数据/策略、真实验证六层筛选,再精读与 DexLab 当前缺口最相关的论文。已单独整理的 Manipulation Benchmark Audit、SuperMimic 和 RLT/CAP 不重复计入推荐。优先级看能否改善物理失败归因、评测可识别性或 sim/real 证据,不看 oral/spotlight 头衔或模型规模。
| 顺序 | 工作与作者证据 | DexLab 应该借什么 | 不能外推什么 |
|---|---|---|---|
| 1. 随机挑战评测 | Stochastic Challenges:两个实验室、Spot/Stretch、568 次真机试验;区分 seed 难度方差与同 seed 试次方差。 | 保存 seed → task → repeat → outcome;预先声明最小重要差值、显著性和 power;方法间保留配对 seed。 | KALLAX 不是灵巧接触物理标定;跨团队场景重建方差未测,成功标签仍需审计。 |
| 2. 分开精度与力失败 | FACT (Spotlight):5 项真机任务、约 2,500 rollouts;作者报告 66% 平均成功,最强对照约 40.5%。 | 记录低幅动作、接触进入/退出、当前力和力历史;用 first-failing-layer 区分没对准与没维持正确力。 | 单机器人/F-T 传感器与架构特定设计,不证明多加力通道必然有效。 |
| 3. 先校准接触事件 | Blind Dexterous Grasping:真实 onset/offset 校准后 onset 误差 426 ms→96 ms,FPR 4.2%→2.2%。 | 在 pinch/hold 记录上先报接触进入/退出时间、F1、FPR,保留空抓、滑移和脱落失败。 | 真机总抓取成功率仅 27%;事件一致性改善不等于稳定抓取已解决。 |
| 4. 柔性任务与分阶段评分 | WireCraft (Spotlight):连接器插入、clip routing、channel seating;铰接链/FEM 线缆和选定 UR5 数据。 | 借到达→插入/坐实的分阶段指标,为切割、绳/线操作冻结难度轴、失败类型、载荷和损伤代理。 | 线缆模型未定量标定,力未验证,不能称物理保真已证明。 |
| 5. 广度先验 vs 精密微调 | Play2Perfect (Oral):先 dexterous play 后精密装配,作者报告比 scratch 省 33× 样本。 | 借对称消融:物体/接触多样性预训练、精密任务微调、容差与阶段成功分开评估。 | 主成功容差 1 cm;紧配合、少量真机试次、位姿跟踪和外部技能编排不是完整自主装配。 |
表中数字是作者报告,不是 DexLab 实测。除公开项目页/仓库外,本轮没有安装运行外部系统。Stochastic Challenges 的完整统计推导、3 张图和 2 张表已另存 Obsidian 笔记。
2026-11-11 蒸馏 · 本体与执行器 / 传感与观测 / 数据与策略 / 验证
最值得借鉴的是把模型决策、动作执行和独立评分拆开记录,再用受控扰动定位失败。这份工作支持把通用语言模型放进机器人动作闭环;它尚不足以支持用语言推理替代快速、连续的接触控制。对 DexLab,优先补齐已有策略适配的动作回执和可复算证据,再讨论扩大模型榜单。
以“夹起剪刀”为教学例子:模型从相机图像估计夹取位置,请求末端移动;工具层检查目标、把抓取点转换到机器人末端、规划并插值关节轨迹;执行后回传实际到达位置和图像,模型再决定修正、闭爪或抬升。最终由环境判定成功。这里的 harness 就是连接模型工具调用与机器人执行的本地程序;它的能力和限制会进入最终成绩。
论文 §3 与附录 A说明主实验没有学习型动作策略,也不给物体真值位姿或深度;但提供机器人状态、几何说明,以及来自 wiki 的任务说明和阶段评分提示。当前源码还明确安排先完成手臂移动,再改变夹爪,并同步双臂轨迹。这些是控制设计;“没有 VLA”不表示没有人工控制先验。
25 Hz 是关节轨迹的执行频率,不能当作模型看图并重新决策的频率。动作块执行期间若接触状态改变,要分别检查动作表示能否表达修正、何时获得新观测、推理与传输用了多久、执行器是否跟上。仅凭失败画面无法把这些因素全部归因于“缺乏物理常识”。
| 证据 | 可以支持的判断 | 解释边界 |
|---|---|---|
| 作者发布 42 项任务、2,100 次试验;本轮从公开逐布局 JSON 复算得 Score 28.97、五维等权 SR 22.48%。 | 在该评测选出的样本中,系统能完成一部分任务。 | 过程 Score 不等于成功率;472/2,100 是另一个微平均口径。单种子和同一仿真器不建立跨场景可靠性。 |
| 同一 JSON 中,精度维度 SR 4%,长时序 8.25%,16 项任务没有成功。 | 总分掩盖了明显的任务差异。 | 不能把总分解释成每类操作都约有两成把握,更不能外推为多指换指能力。 |
| 报告说明真机试验因不安全动作和设备损坏中止;保留样本是诊断材料。 | 仿真成绩之后仍有实际控制与安全边界。 | 未完成官方 18 任务真机协议;其他本体和钢琴案例不能并入这张榜单。 |
数字来源:固定版本逐布局结果、作者报告的真机边界。复算只核对已发布数据的算术,没有重跑机器人或验证原始采集过程。
“同一评分器”还不是“同等输入与预算”。论文明确说公开 VLA 没有补上相同的 wiki 提示重新评测。另有版本差异:论文 §3.3 写默认 100 次模型调用,当前结果说明与代码默认值写 170,并披露按数字按压和模仿排序两个任务使用定向重跑条件。复现时必须逐任务核对实际配置,不能把论文、当前代码与所有历史试验拼成一个完全相同的条件。此处保留差异,不据此推定作弊或数字错误。
示范实验只检验特定的跨布局单示范输入,结果没有总体收益;这不能推出少样本学习普遍无效。扰动实验则选用原本成功的八个布局,没有历史消融或相同扰动下的 VLA 对照,坐标取反后的工具边界也提供了线索。因此可观察到纠正动作,尚不能确认其原因是历史学习,更不能确认这种恢复优于其他控制器。
对 DexLab,更有辨别力的问题是:在当前观测相同的条件下,保留交互历史是否真的提高恢复率?可先用已能稳定执行的任务,比较完整历史与仅当前观测;固定提示、动作转换、模型调用数和环境步数,再加入一种明确的坐标偏差。把语义选择、运动到达、接触保持和最终释放分开计分。只有跨重复试验的收益成立,才值得继续增加记忆机制。以上是候选设计,没有冻结或启动实验。
2026-11-12 的 100 个离线 Code-as-Policy seed/layout 工况成功 19 个;81 个失败的回合级归因中,79 个是策略执行问题、2 个是策略机械问题。因此下方两段局部脱落不能把整批失败都改写成仿真器问题。它们共享“闭爪命令持续为 0、双指法向冲量从约 0.25 N·s 降到接近 0、空夹爪继续闭合”的末端现象,但第一失效链不同:layout 002 有邻片接触放大,layout 011 则先发生平面内转动和上缘余量损失。
接触点比质心高约 4.60 cm;释放附近相邻面包冲量约 0.062 N·s,随后先撞货架。浅夹持受到侧向挤压后,接触法线旋转,面包绕上缘滚出。
接触点只比面包上缘低约 1.4 cm;step 186→188,面包相对腕部的平面内转角约 6.93°→12.45°,OBB 代理上缘余量从 14.41→2.87 mm,之后法向冲量才塌缩。释放前没有邻片或货架冲量。
第一优先级是加深抓取、拒绝窄夹持、增加邻片净空并做低速试提。仿真侧的可验证缺口是:0.07 kg 刚体面包没有压缩、表面粗糙度或指垫顺应性;metadata 与对象加载路径使用的摩擦字段不同,最终 finger–bread 材质 pair 和 combine mode 尚未完整读回;现有记录只有 40 ms 窗内法向冲量峰值和 25 Hz 位姿微分,不含完整切向冲量。它们会影响边缘接触突变的可信度,但当前证据尚未建立 PhysX 求解器错误、真实面包标定或跨引擎排名。
完整中英文报告、参数建议和机器可读指标;其余历史实验按同一结构整理在仿真失败根因图谱。第三栏青色/橙色框是根据刚体位姿和包围盒绘制的诊断代理,不是 PhysX 原生碰撞网格导出。
已有 Poke 适配具备会话与工具回执,任务侧的观测和动作映射仍需逐项接入。沿用当前评分语义审计方向,先为一个合格案例记录完整链条:模型看到什么 → 请求什么 → 工具接受、拒绝或改写什么 → 实际执行什么 → 原生状态如何变化 → 独立评分器判了什么。尤其要保存请求值与实际执行值、动作块时长、到达误差和退出原因;API 成功返回不能代替物理动作成功。
之后再做历史对照和小扰动诊断,并同时报告失败、超时、主动放弃、基础设施错误,以及成本记录缺失。动作块时长和推理等待应分别计时。暂不扩充大规模任务榜单,不新增通用代理框架,也不把模型生成的钢琴控制程序视作已学会通用多指策略。若相同输入和预算的对照显示快速接触控制收益,或另一仿真器及真机重复了优势,再调整这一优先级。
核查日期 2026-11-11;论文 arXiv:2609.24170v1,重点为 §3、§4.5、附录 A/C/D/H;报告网页为当日快照;RoboProbe commit 3c0bc68383a75bf3fa2d7bfc5ab1d1241c7e171e。读取 EEF 动作转换、共享提示构建、结果选择和逐布局数据;公开 JSON 的 42 × 50 个槽位中复算 472 次成功、五维等权 SR 22.4833% 与 Score 28.9708。实际 layout ID 随槽位保留,13 个槽位使用 ID ≥ 50,不能假设每项都是布局 0–49。
效率汇总中 134 个 Astra 已评分 episode 缺 transcript,因此不把缺失调用成本记为零,也不把完整的成功率分母等同于完整的过程审计。公开扰动数据快照仅抽查记录结构。本轮未复跑模型、物理任务、钢琴或真机;源码静态核对和结果算术复算不构成独立实验复现。原有 38 篇论文与 19 个仓库的筛选统计保持其历史范围。
2026-11-12 蒸馏 · 精细接触 / 在线强化 / 评测预算
以 Ethernet 插接为例,找错接口或接触目标不明确更接近 CAP 的目标条件化问题;已经对准却反复试探、退回或接触后犹豫,更接近 RLT 的关键阶段改进问题;碰撞体卡住、力控失配或评分把“到达”误当“插入”,则必须先查几何、柔顺、观测与判据。机械间隙、位姿误差、控制分辨率和成功窗口不能统称为“1 mm 精度”。RLT 没有为 Ethernet 单独给出 1 mm 公差,CAP 也没有公开精密插接实验。
| 工作 | 实际机制与数据 | 证据边界 |
|---|---|---|
| RL Token / RLT | 每项任务先用 1–10 小时遥操作示范适配 VLA;冻结 VLA 后,小型 actor–critic 使用 RL token、状态与参考 action chunk 改进 5–20 秒 critical phase。论文的 400–1000 是在线 episode,作者另报约 15 分钟至 5 小时实际机器人运动数据。 | Ethernet 基础策略已接近高成功率,主要收益是吞吐和减少试探。reset、人工奖励、干预、阶段切换、墙钟、失败与磨损仍须计成本。 |
| Contact-Anchored Policies / CAP | 三维 contact anchor 经深度反投影、正向运动学持续跟踪;20,365 条示范、约 23.1 小时,覆盖 Pick / Open / Close。EgoGym 用于 checkpoint 筛选与失败分析。 | 没有 Ethernet、peg-in-hole 或 1 mm 插接结果;Pick 上的 sim/real checkpoint 相关性不能外推到精密装配,也不能证明 CAP 是 RLT 的低数据替代。 |
目标锚定:坐标系、深度、标定误差与目标更新;关键接触阶段:进入/退出、局部动作、接触和力;交互预算:示范、episode、机器人运动时间、墙钟、reset、干预、失败和磨损;完整任务:从抓取、搬运、对准到插入/锁止定位首次失败。critical-phase reset 与 home-position full-task 分开评测,成功率、完成时间、重试和接触力也分别报告。
只有基础策略稳定到达目标附近、失败集中在最后接触阶段时,RLT 式局部在线强化才是合理候选;只有主要问题是“在哪里交互”时,CAP 式锚定才应优先。组合二者仍是未验证提案。本节是论文与公开入口的静态核查,没有运行策略、checkpoint、仿真或真机实验,也没有新增 DexLab 插接实现。
2026-11-13 · Real2Sim / 状态归属 / 预算与评分
最值得借鉴的是把仿真可信度与模型评测接起来。 先固定真实发出的动作,让仿真自己算出机器人和物体的响应;再用独立条件检验拟合是否有效,最后在明确预算内比较完整任务。平台的场景规模与榜单不应替代这条证据链。完整讨论与取舍
以“抓起杯子、转向、放下”为教学例子:记录关节与夹爪目标,同时保留实际到达、接触建立、持物和释放。如果逐帧写入杯子位姿,只能复现画面;让它通过接触动力学自行运动,才能检查同一输入是否产生相近响应。该例不是作者新增实验。RoboColiseum 平台报告 §1描述约 100 Hz 指令回放与 1 ms 物理子步,并把源后端拟合、冻结参数迁移和目标后端适配分开。
控制、接触与观测残差:强位置反馈能掩盖动力学误差;像素偏差也可能来自相机。DexLab 应保留请求与实测响应、接触事件、观测有效掩码;有效拟合参数与实测材料参数分开。
物理状态与渲染:改外观可以不改接触,但接口相同不保证动力学等价。DexLab 应保留状态所有者、坐标系、时钟、控制与求解配置;跨引擎结论必须保留参数转换与重新拟合条件。
进度、完整成功与成本:子步骤得分、整段任务完成和资源消耗回答不同问题。DexLab 应保留原生评分、完整成功率、推理调用、发出/实际完成的步数、仿真时间与墙钟,保留失败和超时分母。
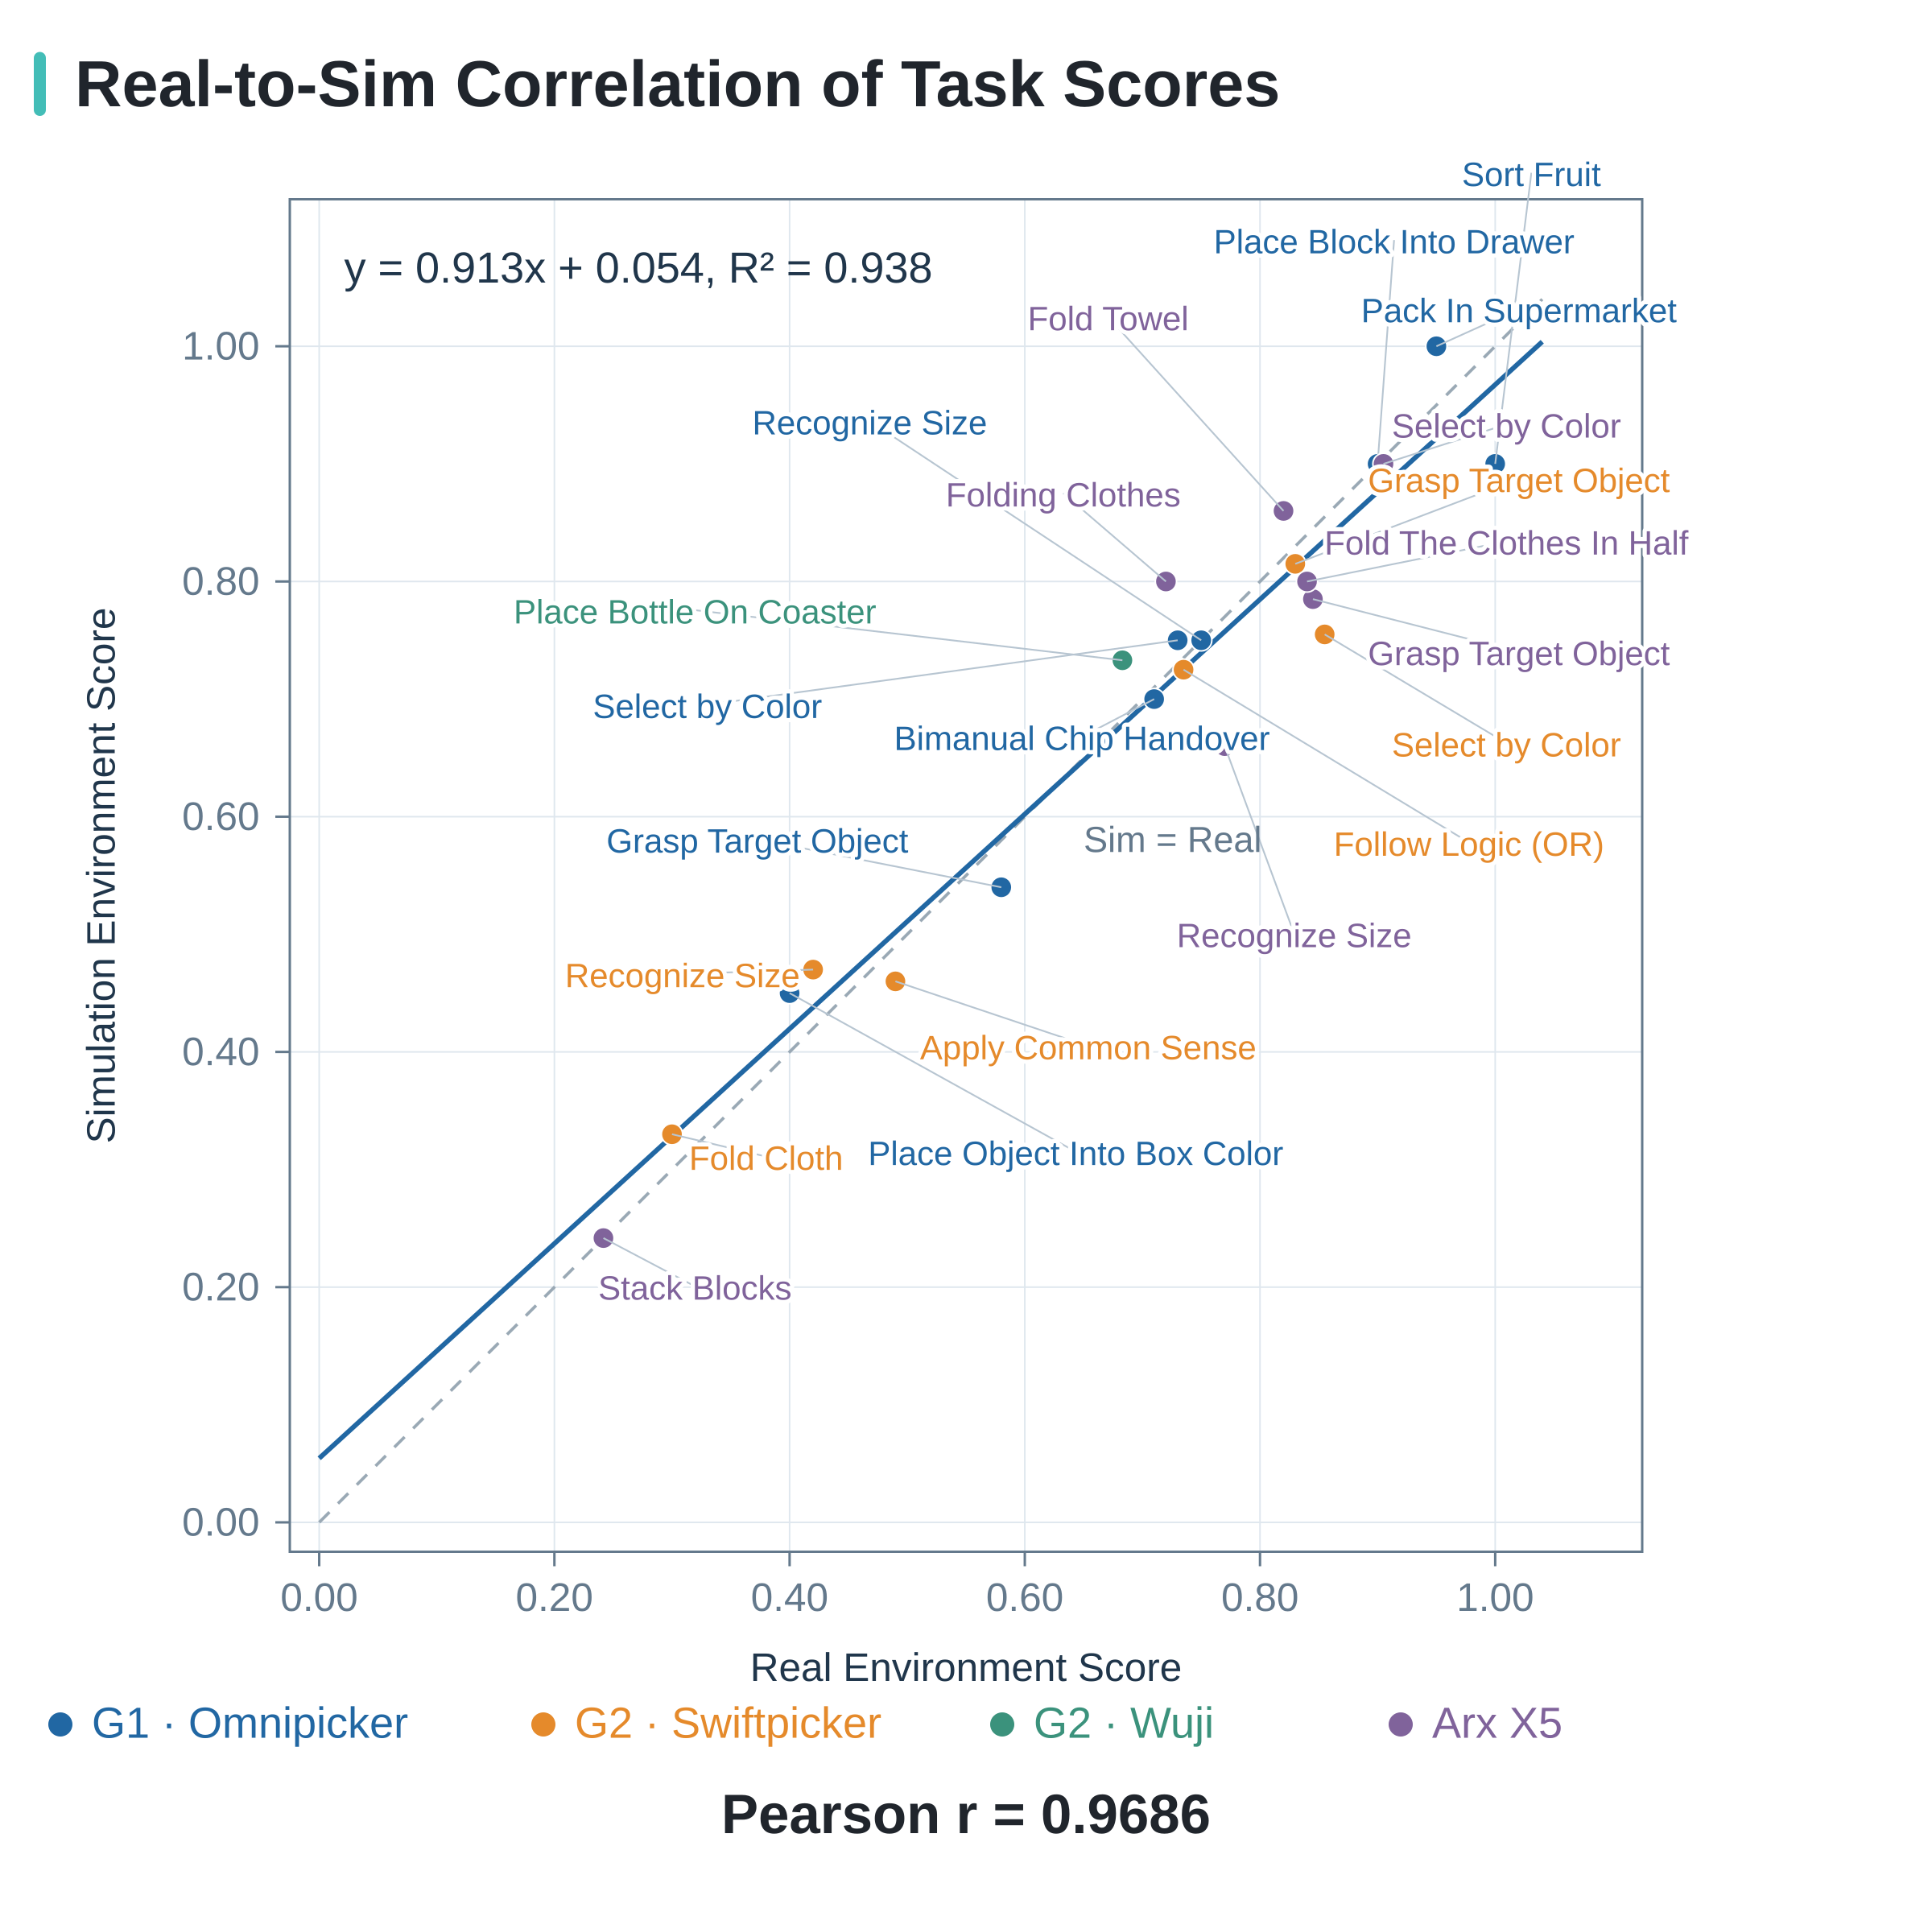
平台 §1.4报告 16 项任务、22 组机器人—任务配对的 Pearson r=0.9686;配对图的拟合为 sim=0.913×real+0.054。这支持已测配置下的分数相关性,不能推出每项误差小于 10%,也不证明固定任务内的模型排名或新任务预测可靠。后两者需要独立留出条件、逐项误差和不确定性;校准一个砝码不能保证整台秤全量程准确,类比只用于说明拟合与验证的分离。
报告 §2.3说明 CPU MuJoCo 推进机器人,连杆状态驱动 libuipc 物体/柔性接触,IPC 接触力不回传 CPU。核查的 Genie Sim 083793f23876 driver已支持可选同步屏障与刚体代理:上一完成时刻的物体状态送入 CPU,本地代理接触可影响机器人,再把机器人状态交给 IPC。这不等于 IPC 原生反力回传或同一步联合求解;默认异步 latest 与显式 barrier 也不能混为同一时间协议。
因此,拉布料的形状演示可以有价值,但要研究布料拉力如何拖慢手、改变腕力矩或触发失握,必须另查反作用如何进入机器人动力学。统一接口、更多子步和漂亮画面都不能替代这个证据。
Season II §3.3描述 Agent 与 VLA/WAM 分榜、固定官方集与动态检查集、执行/推理预算及完整完成奖励;动态集不进入总分。它提供了比单一进度榜更完整的方向,但服务器具体阈值、原始结果与评分版本仍是复算所需条件。不要把 Season I 与 Season II 混成同一排名。
Agent2Act v1 §III-A的主实验按任务等权聚合子步骤分,每个 case 运行一次;这不是完整成功率或重复运行稳定性。其执行层检查并转换模型动作,以后续观测形成反馈,环境独立判分。工具接受、发出动作和物理完成应分别记录。
DexLab 的优先顺序:先沿用评分语义审计,把一条已有合格记录的输入—响应—接触—评分链整理清楚,再设计独立条件和双重预算。 缺少实机数据时,内部一致性可以研究,但不称为 Real2Sim 标定。暂缓整个平台迁移;只有第一失效层明确需要新材料或接触能力时,再按既有 UniSim 分工论证接入。本轮为 2026-11-13 的报告、图表与固定源码核查,没有运行外部模型/仿真或改变 DexLab 物理实现;原论文与仓库筛选统计不变。