DexLab#
Contact-rich robotics, beyond rigid-body simulation.
DexLab 是一个以物理为中心的研究平台,用于研究接触、形变和材料分离条件下的机器人操作。
English · 实验目录 · 研究协议 · 快速开始 · 系统结构 · 论文导读
当前已有原生命令、接触读回、独立评分、离线证据与多项接触实验;远程模型执行器、公开 leaderboard 和跨任务统一结论仍在建设中。
从这里开始#
你想做什么 |
推荐入口 |
|---|---|
先理解灵巧手仿真在研究什么 |
当我们在讨论灵巧操作仿真时,我们在讨论什么?:本机原版,保留六层框架、论文筛选与仓库对照;10 月增补已按原框架归位。 |
看实验、复查结果或复现任务 |
实验目录 → 安装复现;只核对已有证据可从无需 GPU 的擦拭复算开始。 |
理解接触失败与后端差异 |
|
接入模型或理解评测约定 |
模型评测协议;远程执行与公开榜单尚未完成。 |
阅读相关论文 |
Newton 七类论文导读 → 完整书目;其他资料见参考目录。 |
Research vision: Simulation–Learning Co-evolution#
用模型暴露仿真缺口,再用更可信的仿真改善模型。
近期以 Physics Research Platform 为主体:把接触、形变和材料分离做成可观察、可归因、可复算的实验。长期再用模型失败反馈仿真器,用改进后的仿真器训练和评测模型。
Architecture#
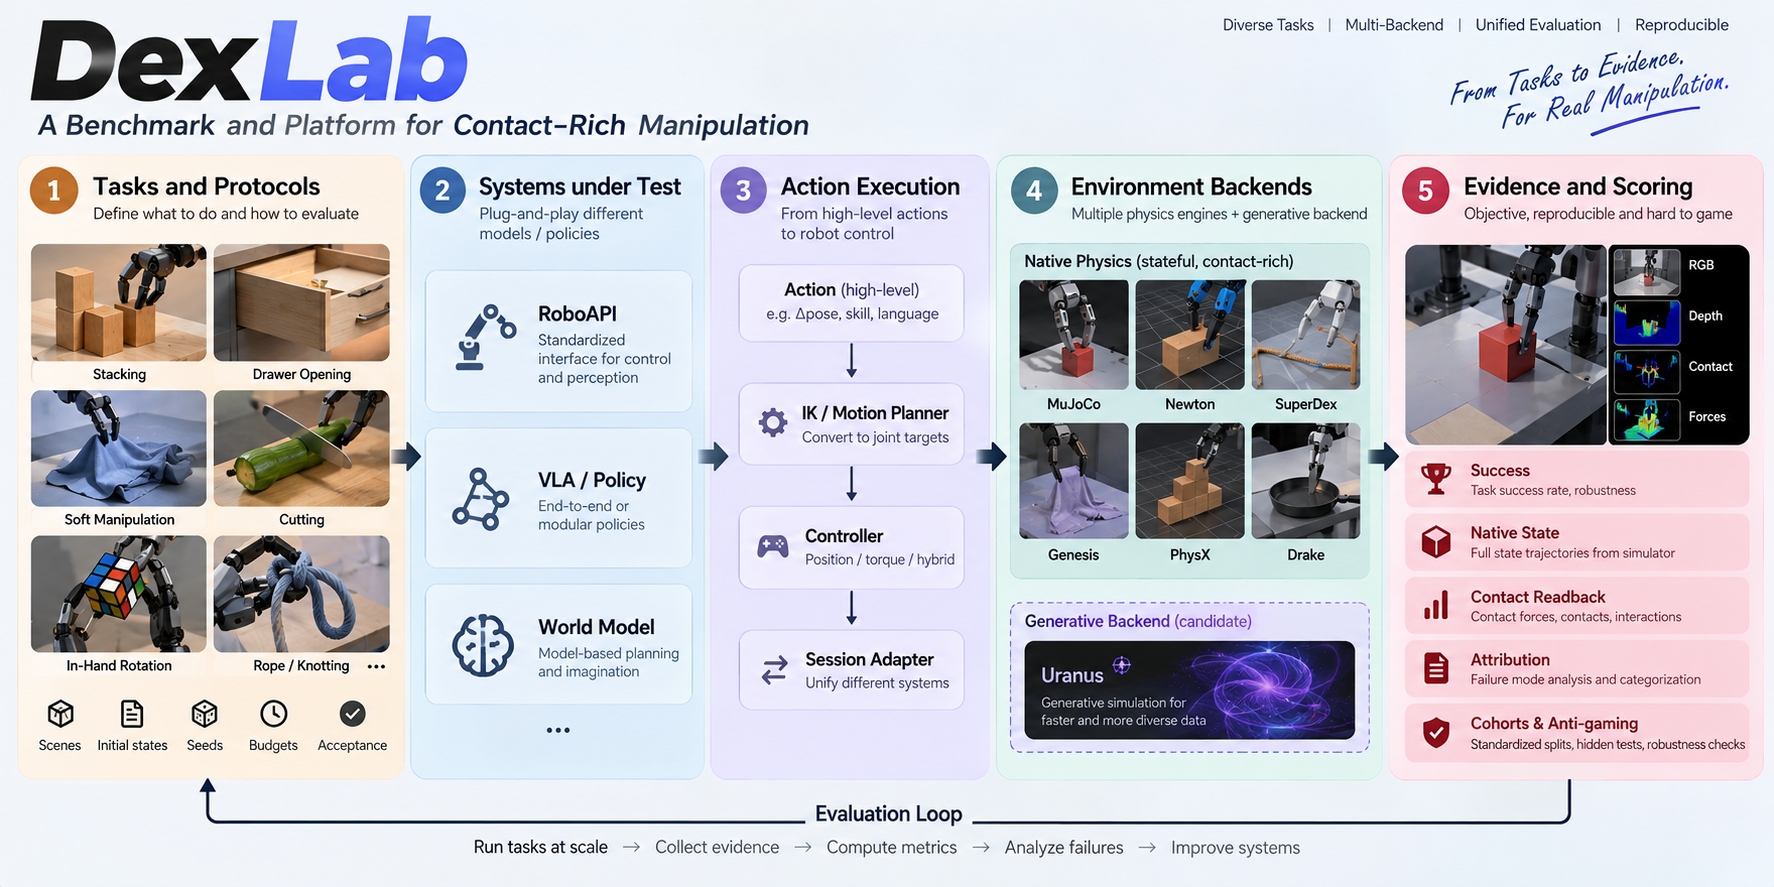
任务协议固定场景与预算;模型输出动作,经控制器映射到物理后端或候选生成式后端;原生状态、接触读回与结果由独立证据层记录和评分。反馈回路只有在对应证据成立后才算完成。
架构图中的任务缩略图用于说明任务类型;真实实验录像和证据见下方实验预览。
Why DexLab?#
机器人策略在仿真中失败时,我们通常只看到一次失败。它可能来自策略、控制器、场景配置、接触离散、材料模型或数值求解。
When a robot fails in simulation, is it the policy that fails, or the physics we trusted?
DexLab 的核心工作不是给单一引擎或模型打总分,而是让下面这些问题可以被实验和证据回答:
相同几何、载荷和控制下,不同接触模型会改变“抓住、滑动、释放”的判断吗?
更小步长、更密网格或更多迭代,真的更接近物理,还是只改变了数值行为?
机器人能夹住布片,何时才会真正完成折叠、送布和正确释放?
切割、摩擦和材料分离应该怎样记录和验收,而不是只看一段视频?
一个 policy 或 API 的排名,能否在替换物理后端后保持不变?
Research areas#
方向 |
研究问题 |
当前入口 |
|---|---|---|
Contact physics |
法向响应、摩擦、保持、滑动、冲量和释放是否能被独立复核? |
|
Deformable objects |
夹持、垂坠、拉伸、层间接触和脱手如何分别验收? |
|
Topology-changing interaction |
切割和材料分离如何记录接触、连通性与材料响应? |
|
Cross-backend evaluation |
相同物理目标和控制下,不同引擎、积分器与求解器何时可以比较? |
|
Policy and API evaluation |
模型失败、适配器失败和物理无效运行如何分开? |
实验预览#
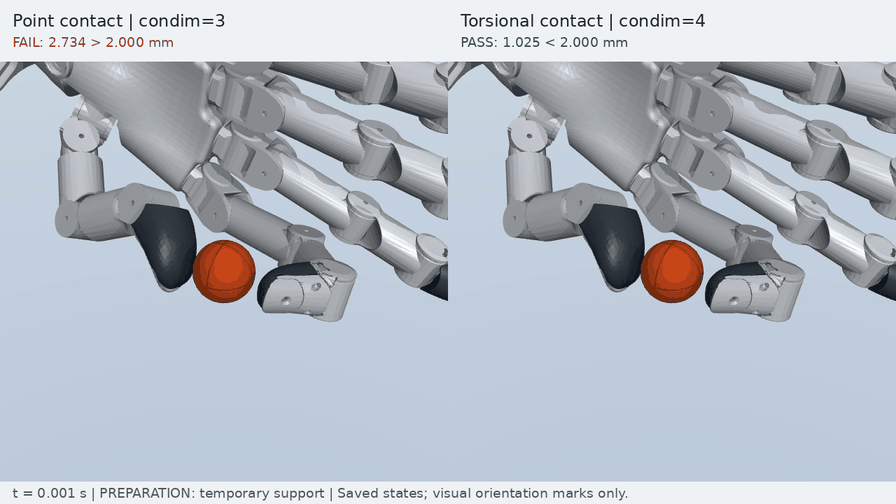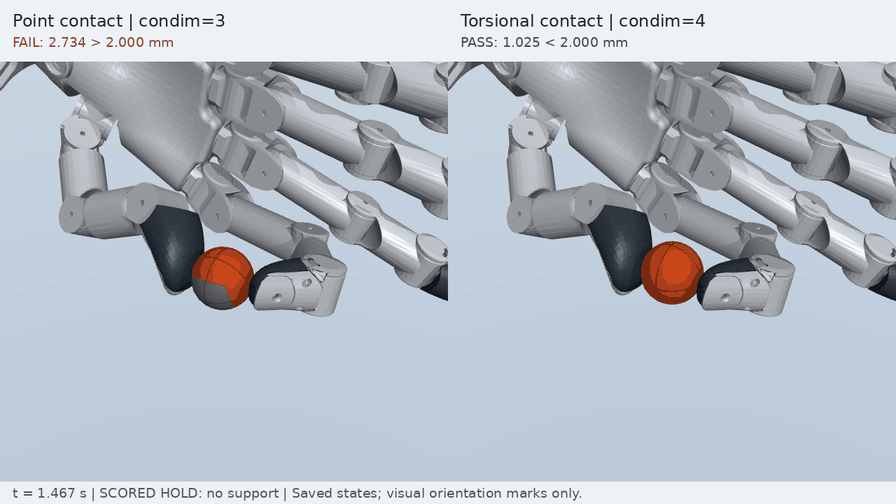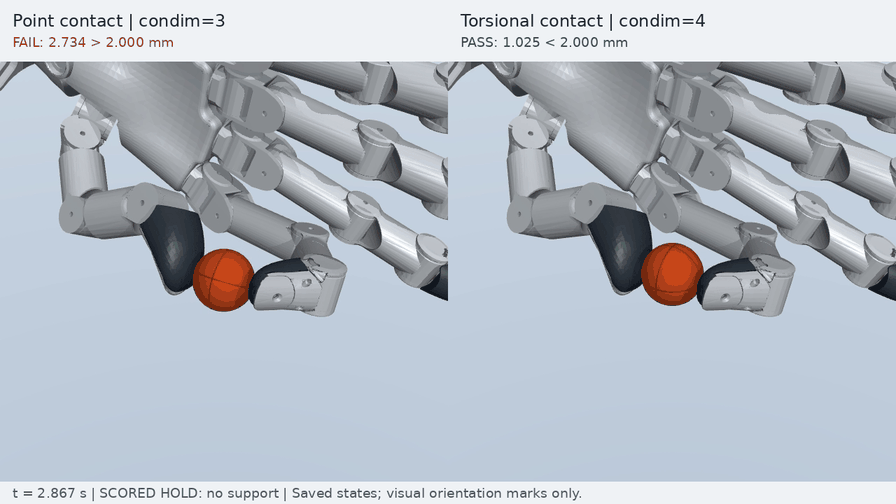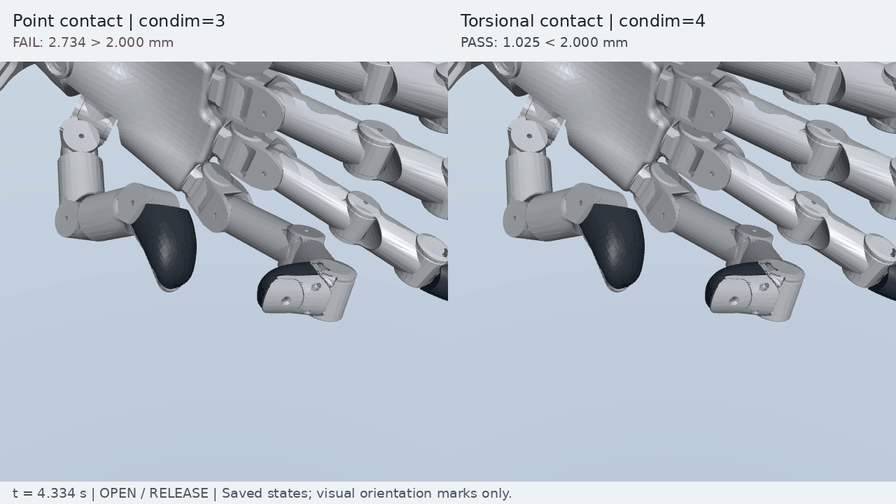
以下动图来自 DexLab 的真实仿真录像或记录状态回放。每项结果只适用于对应版本、材料假设和验收协议。
抓取与抗滑移 |
海绵擦拭与接触依赖 |
|---|---|
|
|
柔性物体操作 |
切割与拓扑变化 |
|
|
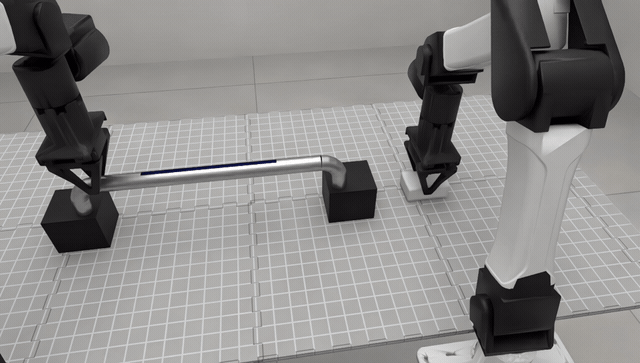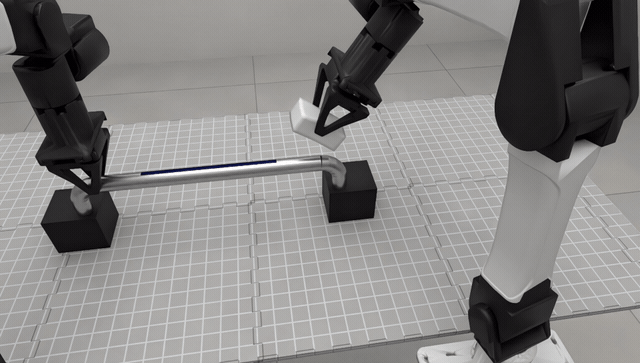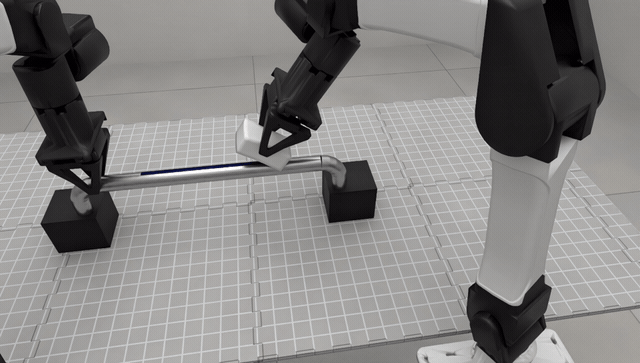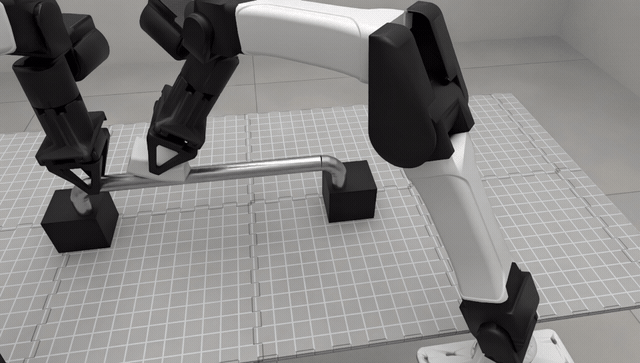
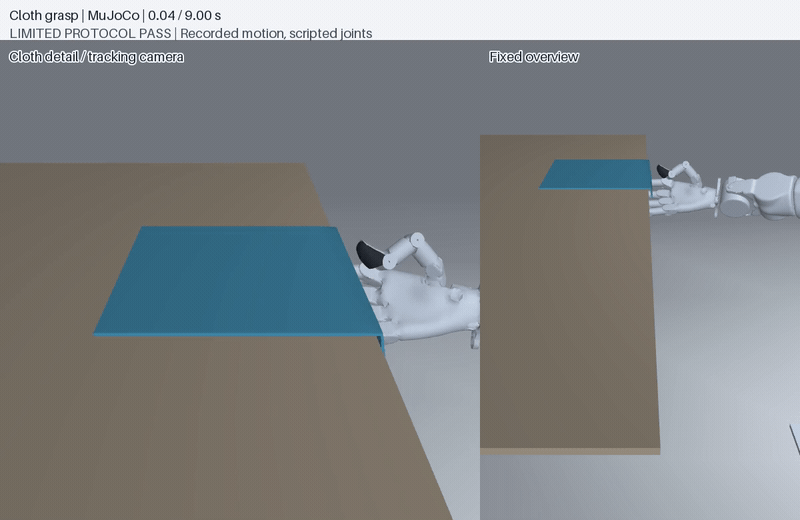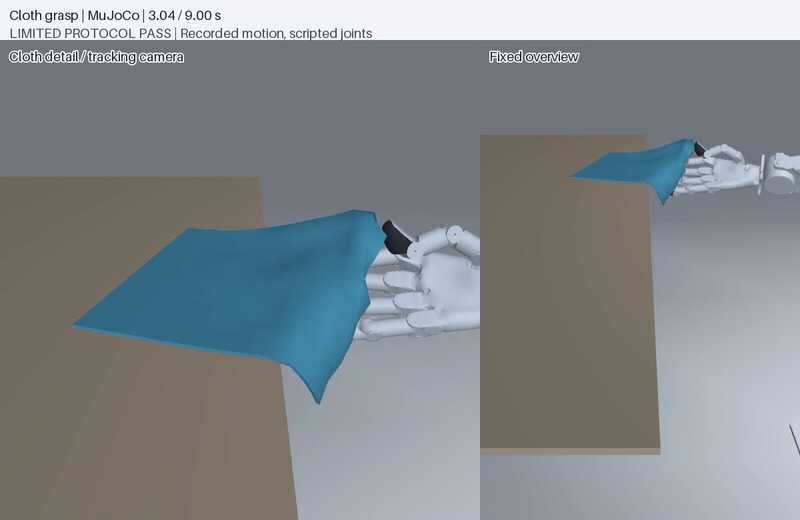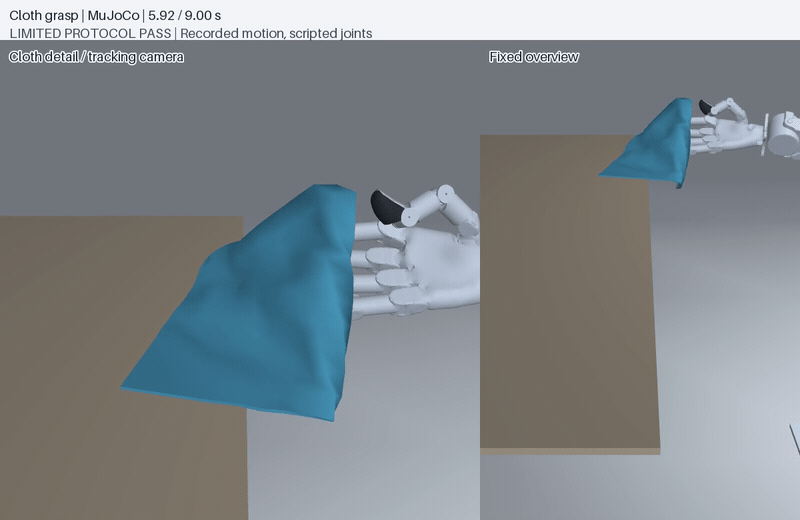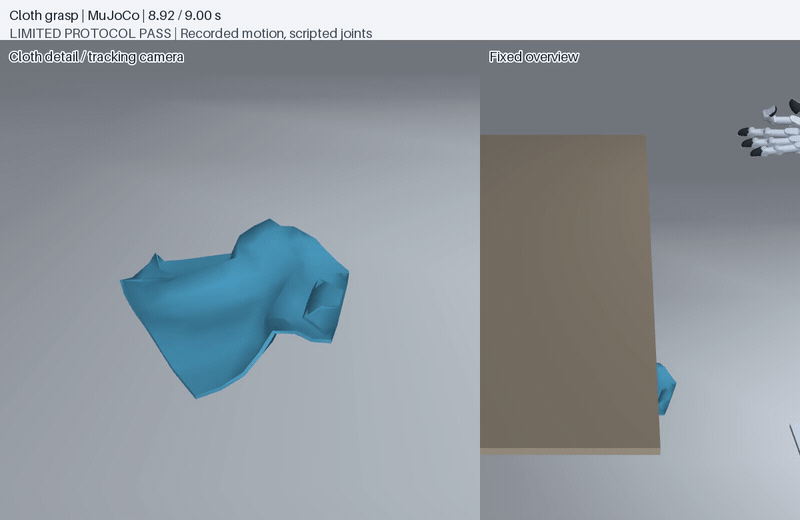
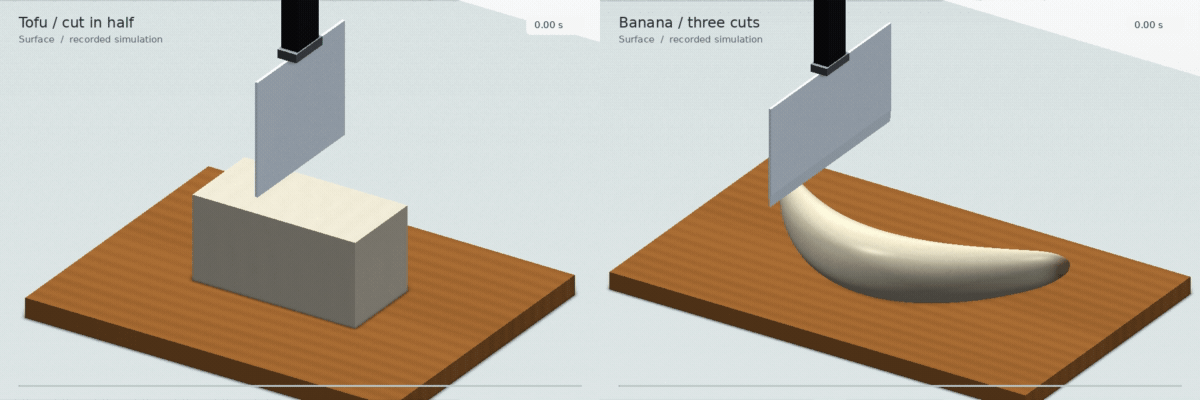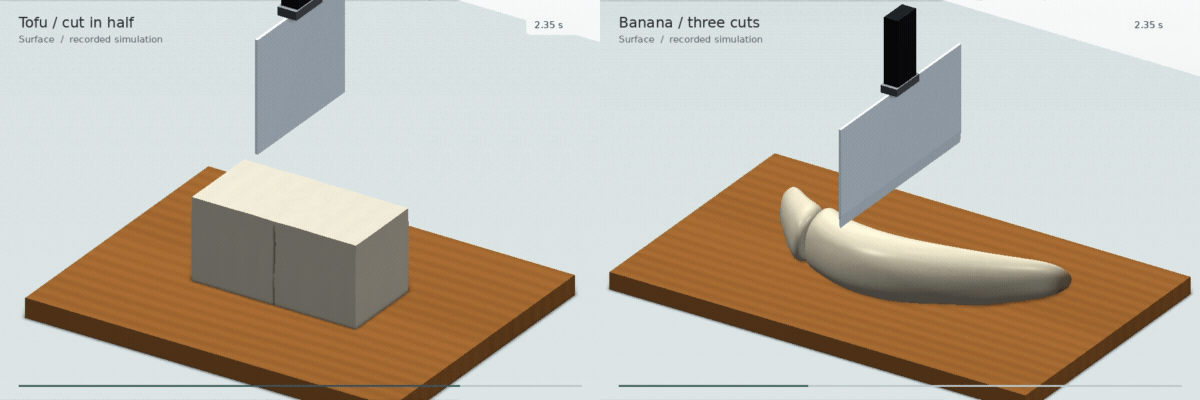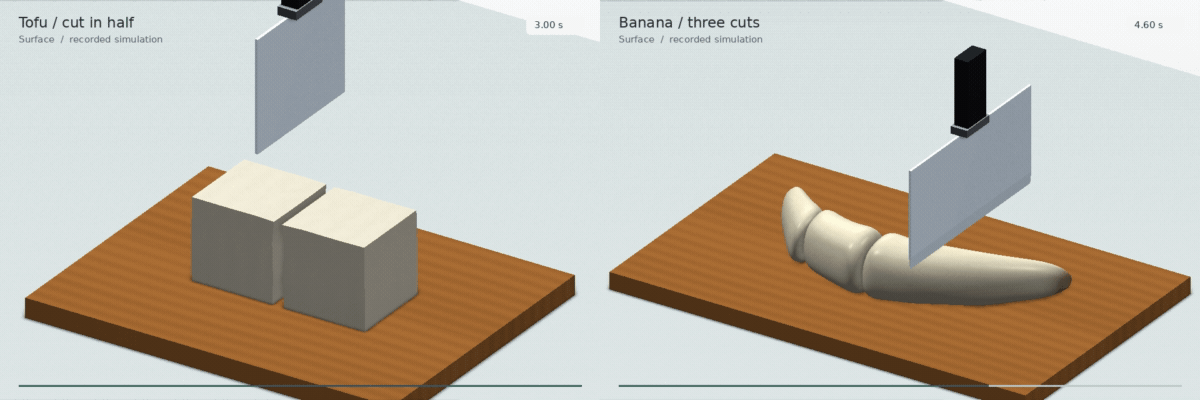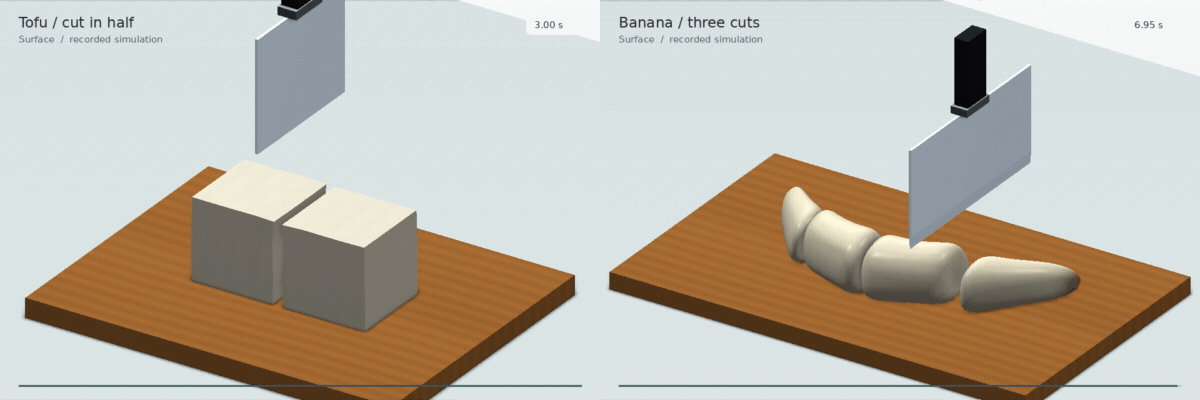
Experiments and findings#
实验 |
条件 |
结果和解释 |
|---|---|---|
接触表示改变抓取结论 |
Wuji 双指夹球,相同控制和保持窗口 |
|
擦拭成功率依赖辅助保持 |
RoboSimStudio |
原版 3/3,清洁率约 95.47%;去掉辅助后 0/3,约 39.92%。 |
接触离散改变失效边界 |
同一圆柱、质量、力命令和步长,只改变表面三角数 |
|
同场景抓取可能依赖于后端 |
苹果抓梗,10 个配对回归场景 |
当前默认配置 MuJoCo 通过 1/10,SuperDex 通过 10/10;更小步长没有单调改善穿透。 |
夹住布不等于完成折叠 |
OpenArm + Wuji,被动布料 |
单手夹点、抬升与释放通过;完整折叠因应变、残余接触和最终几何未达标而失败。 |
这些结果共同指向一个问题:成功视频不足以证明材料模型、接触响应和下游策略都可迁移。
来抓一只娃娃#
用方向键、WASD 或屏幕按钮移动爪子,瞄准后按空格或「下爪」。三爪会自动下降、合拢、提起并送往金色取物口;玩偶真正落进盒子并停稳,才算抓到。下爪后,Newton、CG、PGS 从相同状态同步抓取;三路统一使用 elliptic 摩擦锥、implicitfast 和 2 ms 步长。抓取结束后可以拖动共同时间轴、慢放,或调整迭代上限后「原局重试」。重新瞄准时继续 Newton 那一柜。
MuJoCo 在你的浏览器本地计算接触。一柜固定混放 30 只、覆盖全部 16 款奶家族角色,无需选择组合;放大的娃娃经重力下落自然堆叠,夹爪按堆顶高度下爪。深紫星月机柜配粉色灯条和猫耳夹爪,点头像可近看真实网格。它们由本地图生 3D 模型生成毛绒外观,物理上仍是使用近似碰撞外形的合成刚体;抓取没有吸附或随机中奖,也不代表软体玩偶或真机验证。实验下方解释三种求解器,以及显式、半隐式、隐式积分的区别。三路结果可能一致;抓到娃娃不等于物理模型更准确。
页面优先使用本地 WebGPU,不支持时自动回退 WebGL 2,并显示实际后端。物理与回放在独立 Worker 中运行;手机限制渲染分辨率和帧率,并使用轻量网格与贴图。三路仍共用原来的碰撞模型、2 ms 步长和迭代预算;设备算得慢时仿真时间会慢于现实时间。
Quick start#
Linux x86_64 上安装 uv 后,运行苹果抓梗:
git clone https://github.com/huangkiki/Dexlab.git
cd Dexlab
bash scripts/setup.sh --mujoco-profile historical-3.11.0
bash demos/apple-stem-grasp/run.sh \
  --backend mujoco \
  --output demos/apple-stem-grasp/runs/first-mujoco
.venv/bin/python demos/apple-stem-grasp/src/verify_sdf_grasp.py \
  demos/apple-stem-grasp/runs/first-mujoco
验收器会写出 summary.json;全部检查通过时 passed: true。14 秒是仿真时长,实际计算通常更久。无桌面环境添加 --headless,每次运行使用新输出目录。
如果只想检查证据链、不安装仿真器,可从安装与最小复现开始。完整依赖、资产和命令见该页。
Research roadmap#
Contact and material response: 将接触刚度、阻尼、摩擦与真实测量分开校准,再讨论 engine ranking。
Deformable manipulation: 从夹持、送布和释放扩展到可复核的折叠几何、自接触和材料点跟踪。
Topology-changing tasks: 为切割、分离和粘连建立连续几何、接触力与结果判据。
Cross-backend attribution: 区分 solver、integrator、collision geometry、precision、timestep 和 framework wrapper。
Policy and neural backends: 检查 API 排名和任务结论能否从原生物理迁移到 learned world model。
Co-evolution: 在证据支持后,用模型失败推动仿真改进,再用改进的仿真产生更可信的策略训练与评测。
CHORD 迁移准备: 已有固定任务卡、资产预检和有限上游命令准备入口;原生训练、记录与评分尚待贯通(0/3)。准备任务。
Ecosystem backend: Uranus#
Uranus 是 D-Robotics 的机器人视频世界模型,从未来 qpos、相机和机器人结构生成多视角观测。它目前是 documented candidate generative backend,不是已验证物理后端。
接入链路为 RoboAPI → IK/controller → qpos → Uranus → RGB → task scorer。它提供视觉观测,不提供原生接触状态、任务 success 或物理真值。阅读完整介绍、候选任务和证据边界。
Evidence and boundaries#
任务成功不等于物理真实;数值一致不等于现实正确。
仿真通过不等于真机成功;渲染通过不等于视觉控制。
不同引擎覆盖的任务、材料模型和验收条件不同,不是统一排行榜。
失败、无效运行和缺失读数都必须保留;不通过放宽阈值或删除反例制造成功。
Uranus 和远程模型评测仍是候选能力,不应从论文或接口存在推断 DexLab 已完成复现。
Documentation and citation#
实验目录 · 研究经验 · 求解配置 · 覆盖矩阵 · 参与贡献 · 当前工作与暂停状态
项目尚未发布配套论文;引用本仓库时请使用仓库 URL 和具体 commit / release,而不是引用尚未存在的论文结果。
@software{dexlab2026,
  author  = {DexLab contributors},
  title   = {DexLab: A Physics-Centric Research Platform for Contact-Rich Robot Manipulation},
  year    = {2026},
  url     = {https://github.com/huangkiki/Dexlab}
}